此前各章都在为问题设计算法、证明复杂度上界;计算复杂性则反过来问:一个问题最好能做到多快,能否证明不存在高效算法?要谈论「不存在」,必须先把「算法」精确化,这就是图灵机。
1. 引入:复杂性理论问什么
复杂性理论有两个层次:
低层:理解单个问题的难度,即最优算法的效率。一面是找到最好的算法(上界),一面是证明不存在高效算法(下界);
高层:探索问题之间、概念之间的联系。例如,若某个问题有高效算法,另一批问题是否随之也有?
典型的问题包括:两个数相乘能多快(分治中的 Karatsuba 已推翻了 的猜想,见分治)?哈密顿圈问题,暴力搜索是否已是最快?允许算法抛硬币并以小概率出错,能否显著加速?一般地,一个问题相对于时间、空间、随机性等计算资源有多难?
后续的主题依次是:图灵机、P、NP、NPC 与归约,以及对角线法、空间复杂性、多项式谱系、布尔电路、随机计算、交互证明、密码学、PCP 与近似难度等。本章先建立模型。
参考书
S. Arora, B. Barak. Computational Complexity: A Modern Approach. Cambridge University Press, 2009;O. Goldreich. Computational Complexity: A Conceptual Perspective. Cambridge University Press, 2008。
2. 计算任务:串、语言与判定
计算是把对象的一种表示变成同一对象的另一种表示。统一的表示是二进制串:
串是有限的 0/1 序列, 的长度记作 ,全体串记作 。 表示 与 构成的有序对的某种(可高效编码、解码的)串表示。
整数、图、向量、矩阵乃至几乎一切计算对象都能编码成串,例如 个顶点的图用邻接矩阵按行拼接成长为 的串,也可以用邻接表编码成长为 的串。两种编码的长度至多相差一个多项式,所以它们不影响「多项式时间」的判断。
唯一需要警惕的是数: 的二进制编码长度为 ,一元编码 的长度为 ,二者呈指数关系。复杂度总是相对于输入长度 衡量的,于是同一个算法换一种编码,结论可能完全不同。
例:试除法是多项式时间的吗?
判定 是否为素数,最朴素的办法是用 逐个去除,共 次除法。若 以一元给出,输入长度为 ,这是线性时间;若以二进制给出,输入长度 , 便是指数时间。密码学中的 有上千位,试除法毫无用处,「素数判定属于 P」(AKS,2002)指的是关于 的多项式。后面的子集和、划分等数值问题都会遇到同样的区分(伪多项式时间)。
布尔函数 将串映到一个比特。将 等同于集合 ,称为语言或判定问题:给定 ,判定是否 。搜索问题则要求对给定实例找出相应的解。
计算 与判定 视为同一个问题。只研究判定问题看似狭窄,但对后面关心的问题,搜索与判定往往是等价的(见NP 完全问题中「判定与搜索」一节)。
3. 计算模型:图灵机
图灵机可以看作简化的现代计算机:纸带对应内存,转移函数与寄存器对应 CPU。
带图灵机 由以下部分组成:
- 有限字母表 ,其中 为空白符, 为起始符;
- 条单向无限的纸带:一条只读的输入带、若干工作带、一条输出带,每条带各有一个读写头;
- 有限状态集 ,含起始状态 与停机状态 ;
- 转移函数 :根据当前状态与 个读写头读到的符号,决定新状态、在 条可写带上写入的符号,以及每个读写头左移、不动或右移。
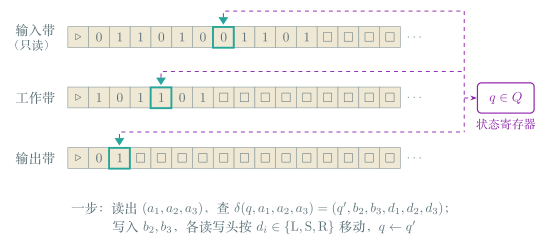
设 ,。称 计算 ,若对任意 , 从输入 的初始格局出发,停机时输出带上恰为 ;称 在 时间内计算 ,若对任意 , 至多走 步。
把某一时刻的「全部状况」打包起来,就是格局:当前状态、各条带的内容、各读写头的位置。初始格局由输入 决定,转移函数把一个格局变成下一个格局,一次计算就是一串格局 。值得注意的是,相邻两个格局只在读写头附近的常数个格子上不同。这一「局部性」看似平凡,却是后面 Cook–Levin 定理的核心:正因为每一步只改动常数个比特,整个计算才能被多项式个小约束刻画。
回文判定:给出一台图灵机,在 时间内判定 是否为回文。
用一条工作带:第一遍从左到右把 复制到工作带;然后输入带头回到最左端,工作带头停在最右端;两个头相向移动并逐位比较,遇到不同的符号就输出 0,扫描完毕输出 1。三遍扫描共 步。
图灵机的细节(字母表大小、带的条数、带是否双向无限)都不影响「多项式时间」的概念:
设 可由图灵机 在 时间内计算,则:
- 它可由只用字母表 的图灵机在 时间内计算;
- 若 有 条工作带,它可由只有一条工作带(外加输入、输出带)的图灵机在 时间内计算;
- 若 的纸带双向无限,它可由标准图灵机在 时间内计算。
字母表:把 中的每个符号编码为 个比特。模拟一步时,先读出当前符号对应的 个格子(状态中记住读到的内容),再回头改写,最后移动到相邻符号的编码处,每步至多 步。
带数:把 条带「交织」到一条带上:第 格存放 条带第 格的符号构成的 元组,并用带标记的符号 记录各读写头所在的位置(字母表扩大为 )。模拟一步时,从左到右扫一遍收集 个被标记的符号,再扫一遍完成写入并移动标记。 步内纸带至多用到 格,故每步 ,共 。
双向带:把双向带在原点处对折,新带的第 格存放原带第 格与第 格组成的符号对,状态中记住当前位于哪一半;读写头在负半边向左移动时,在新带上改为向右移动。每步至多 步。
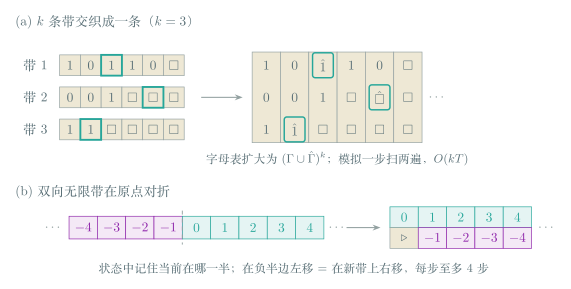
以上开销都是多项式的,而多项式在复合下封闭,因此「多项式时间可计算」与采用哪种合理的图灵机变体无关。今后可以自由使用多带图灵机,乃至用伪代码描述算法。
4. Church–Turing 论题
一个函数能被某台图灵机计算,当且仅当它能被任何其他「合理且通用」的计算模型计算。
这是论题而非定理:「合理且通用的计算模型」是一个直观概念,没有数学定义。「合理」指计算规则在直观上足够简单;「通用」指模型能计算一切直观上可计算的函数。它是关于世界本性的一种信念。据此定义:
函数 是可计算的,若存在图灵机在有限步内计算 。
强 Church–Turing 论题
更强的版本断言:任何合理模型上多项式时间可计算的问题,在图灵机上也是多项式时间可计算的。可计算性层面几乎无人怀疑原论题,但「高效可计算」层面的情形不那么清楚:随机算法、尤其是量子计算机(Shor 算法能在多项式时间内分解整数)都对强论题构成了挑战。
5. 时间复杂性类 DTIME 与 P
语言 ,若存在图灵机 与常数 ,使对任意 , 在 步内输出 。
称 是时间可构造的,若 ,且存在图灵机在 时间内计算 ( 的二进制表示)。
模型只影响多项式因子,但确实会影响指数
回文判定在两带图灵机上是 的(第 3 节)。若只允许一条纸带(输入也写在这条带上),可以用「交叉序列」论证证明任何单带机都需要 步:读写头必须把前半段的信息「搬运」到后半段,而每越过中间的某个边界一次只能携带常数比特的状态。这与第 3 节「 带变一带至多平方」的上界恰好吻合。所以 这样的精细类依赖于模型,而 P 不依赖。
时间可构造性是一个技术性条件,保证机器能「给自己计时」:先算出 ,再在这个步数内停下。 等常见函数都是时间可构造的。
P 刻画了「有可行判定过程」的问题,多项式时间被认为是高效、可行的。前面各章的算法(稳定匹配、BFS、最短路、最小生成树、FFT 等)都说明了相应问题属于 P(或其搜索版本可在多项式时间内求解)。选择多项式作为分界的理由是:
封闭性:多项式在加法、乘法与复合下封闭,多项式时间算法调用多项式时间子程序仍是多项式时间;
鲁棒性:由第 3 节,P 不依赖于图灵机的具体变体;
分水岭:对自然问题,一旦找到多项式算法,指数通常很快被降到很小;而多项式与指数之间的差距是本质性的。
但 P 也有局限:
最坏情形过严:P 要求每个输入都快,而有的算法最坏情形很慢、实际中却很好用(如单纯形法),这引出平均情形与平滑分析;
对「高效」的质疑: 的算法并不实用,而强 Church–Turing 论题本身也受到随机与量子计算的挑战;
判定问题过窄:许多实际问题是搜索或优化问题,不过它们与判定版本往往等价。
6. 机器即串:通用图灵机
图灵机的行为完全由转移函数决定,而转移函数是有限的表,把它的全部输入输出列出来就得到一个串:
每台图灵机 都可表示为一个有限串 ;
每台图灵机都有无穷多个表示:在末尾添加任意多个被忽略的 1 即可;
每个串 都表示某台图灵机 :不合法的串约定表示一台立即停机、输出 0 的平凡机器。
「机器即串」意味着机器可以作为另一台机器的输入。
存在图灵机 ,使对任意 有 ;并且若 在输入 上 步内停机,则 在 步内停机,其中 与 无关,只依赖于 的字母表大小、带数与状态数。
定理有两层意思:存在一台能模拟一切机器的固定机器(正确性),以及这种模拟只慢一个对数因子(效率)。前者是可计算性的结论,后者是复杂性的结论。下面分开证明,先给出 的朴素模拟,再把它改进到 。
算法实现
\begin{algorithm}
\caption{Universal-TM:模拟 $M_\alpha$ 在 $x$ 上的计算}
\begin{algorithmic}
\PROCEDURE{Universal}{$x, \alpha$}
  \STATE 把 $M_\alpha$ 的转移函数表写到工作带 1 \COMMENT{长度只依赖于 $M_\alpha$,视为常数}
  \STATE 把 $M_\alpha$ 的当前状态 $q \gets q_{\mathrm{start}}$ 写到工作带 2
  \STATE 把 $M_\alpha$ 的 $k$ 条带作为 $k$ 条轨道交织在工作带 3 上 \COMMENT{同第 3 节的带数归约}
  \WHILE{$q \neq q_{\mathrm{halt}}$}
    \STATE 收集 $M_\alpha$ 各读写头当前读到的符号 $(a_1, \dots, a_k)$
    \STATE 在转移表中查找 $\delta(q, a_1, \dots, a_k) = (q', b_2, \dots, b_k, d_1, \dots, d_k)$
    \STATE 写入 $b_2, \dots, b_k$,按 $d_1, \dots, d_k$ 移动读写头,$q \gets q'$
  \ENDWHILE
  \RETURN $M_\alpha$ 输出带上的内容
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
正确性。 按上面的循环逐步模拟 :每一轮恰好对应 的一步,且 维护的状态、带内容、读写头位置与 的格局一一对应(对步数归纳)。若 停机, 在对应的轮次退出循环并输出相同的内容;若 不停机,循环永不结束, 也不停机。故 。
常数从哪里来。 是一台固定的机器,字母表与带数事先定死,而 可以有任意大的字母表 、任意多条带与任意多个状态。于是 把 中的符号编码成长为 的比特块,把 条带放在同一条带的 条轨道上,并在每一轮扫描整张转移表来查找 。这些操作的开销只依赖于 ,不依赖于 ,全部吸收进常数 。
朴素模拟:。 在 步内每条带至多用到 格。若用带标记的符号记录各读写头的位置,模拟一步就要从左到右扫一遍轨道带收集 ,再扫一遍完成写入与标记的移动,每步 ,共 。慢的原因是各读写头可能相距很远,每一步都要跨越整段纸带。
改进:不动读写头,改动纸带。 让每条轨道上「当前被读的格子」始终位于 的第 格。 的读写头右移,就把这条轨道的内容整体左移一格。直接平移仍要 ,诀窍是在纸带上预留空位(记作 ),使绝大多数平移只搬动第 格附近的少量符号。
对每条轨道,把第 格右侧依次划分为区段 , 占 格;左侧对称地划分为 。约定:
- 每个区段中非空位符号的个数只能是 、 或 ,分别称为空、半满、满;
- 的带上读写头右侧的内容,就是 中的非空位符号依次连接,左侧同理;
- 不变量:对每个 ,,即 要么都半满,要么一满一空。
开始时所有区段都是半满的(用空白符 填充),需要时再在外侧开辟新的半满区段。模拟一次「纸带左移」:
- 找最小的 使 非空。此时 全空,由不变量, 全满;
- 从 取出最靠内侧的 个符号:第一个放进第 格,其余 个按顺序填进 ,使它们各自半满;
- 原第 格的符号与 中的符号共 个,按原顺序重新分配:前 个使 各自半满,后 个并入 的内侧。
所有符号的先后次序不变,所以约定 2 保持。对 , 都变成半满; 减少 个、 增加 个,和不变,所以不变量保持( 非空故至少有 个, 至多有 个,不会溢出)。这次操作只涉及 之间的 个格子,借助一条辅助工作带复制,用时 。右移对称。
摊还。 称上述操作发生在第 层。一次第 层操作之后, 中恰有 个符号;此后每次低于第 层的操作恰好使这个数加 或减 (取出 个、放回 个,或反之)。同一条轨道上要再发生一次第 层或更高层的操作,必须先把 清空或把 清空,这至少需要 步。所以 步中第 层()操作至多发生 次,总代价
其中只需 层,因为 步内纸带上的内容离读写头不超过 格。 条轨道各自如此,再乘上查表与编码的常数,即得 。
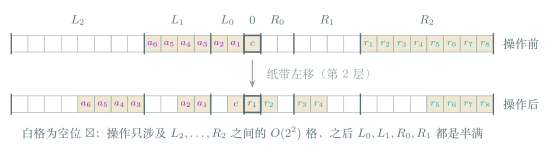
这一证明属于 Hennie–Stearns(1966),这里采用 Arora–Barak 的区段写法。它的思想与动态数组的倍增扩容一致:偶尔做一次大搬运,但大搬运之间必然隔着许多次小操作,平均下来每步只付出 。
时间分层定理
的模拟开销正是下面结论中 因子的来源:若 时间可构造且 ,则 。证明用第 7 节的对角线法:构造机器 ,在输入 上用 模拟 共 步,然后输出相反的结果。任何 时间的机器都会在其某个足够长的表示 上与 不同。特别地 。
7. 不可计算函数
若没有图灵机能在所有输入上停机并正确求解某问题,则称该问题不可计算(不可判定)。
存在不能被任何图灵机计算的函数。
定义 :若 ,则 ;否则( 输出其他值或不停机)。
假设 可计算,即存在图灵机 ,使对任意 有 。把 自己的描述喂给它:取 ,则 。分两种情形:
- 若 ,则按 的定义 ;
- 若 (输出别的值或不停机),则 。
两种情形都与 矛盾。
证明的关键一步是「把机器的描述作为它自己的输入」,这只有在机器即串的视角下才有意义。这一技术称为对角线法。把所有串按字典序排列,构造一张无穷表格,第 行第 列为 ( 表示不停机或输出不在 中):
是把对角线「取反」(,其余 )得到的一行,它与每一行都在对角线位置上不同。由于所有图灵机都出现在表的行中, 不是任何图灵机计算的函数。
看起来是人为构造的,但它可以导出一个极其自然的问题的不可计算性:
定义 , 当且仅当 在输入 上停机。则 不可计算。
假设图灵机 计算 ,构造计算 的机器:在输入 上运行 ;若输出 0,则 不停机,输出 ;否则 必停机,用通用机模拟得到 ,输出 。这台机器总是停机,与上一定理矛盾。
证明的结构是:若 HALT 可计算,则 UC 可计算。这就是归约的雏形,它将在 NP 完全性中成为核心工具。图灵的这项工作受 Gödel 不完备定理启发,反过来,不可计算性也给出了不完备定理(可能是)最简单的证明。
停机问题并非孤例。同样的归约说明,关于程序行为的几乎一切非平凡问题都不可判定:
设 是可计算函数的一个性质,既非所有可计算函数都具有,也非都不具有。则 不可判定。
记 为处处不停机的函数,不妨设 (否则对 的补集论证,可判定性对取补封闭)。由非平凡性,存在机器 ,它计算的函数属于 。
把 HALT 归约到 :给定 ,构造机器 ,它在输入 上先模拟 ,若模拟结束,再运行 并输出其结果。 的描述可由 机械地写出。若 在 上停机, 计算的就是 的函数,属于 ;否则 在任何输入上都不停机,计算的是 。于是 在 上停机 ,判定 就能判定 HALT。
例如「程序是否对所有输入输出 0」「两个程序是否计算同一个函数」「程序是否会访问某个变量」等静态分析问题都不可判定。实际的程序分析工具因此只能近似:要么允许误报,要么允许漏报,要么不保证终止。
可判定与半可判定
HALT 虽然不可判定,却是半可判定的:用通用机模拟 ,若它停机就输出 1。这台机器在「是」实例上总会停机并接受,在「否」实例上永远运行下去。反过来, 不是半可判定的:否则把两台半判定机交替各模拟一步,总有一台会停下,就得到 HALT 的判定机。「是」实例有有限的证据(停机的计算过程),「否」实例没有,这种不对称与后面 NP 与 coNP 的不对称如出一辙:NP 要求证据还必须短、验证必须快。
事实上,不可计算函数不仅存在,而且占绝大多数:
可计算函数的集合是可数的,而从串到比特的全体函数的集合是不可数的。
每个可计算函数都由某台有有限描述的机器计算,于是存在从可计算函数到 的单射,而 与 一一对应,故可计算函数可数。
另一方面,将 与 等同,把 对应到函数 , 为 二进制展开的第 位(取不以无穷个 1 结尾的展开),这是 到布尔函数集的单射,故布尔函数集不可数。
这个论证只依赖于「合理模型中每台机器都有有限描述」这一前提,与图灵机的细节无关;而其中的不可数性证明正是 Cantor 的对角线法。
8. 小结
| 概念 | 定义 | 要点 |
|---|---|---|
| 语言 | 判定问题,复杂度相对输入长度衡量 | |
| 图灵机 | 字母表、带数、双向带只影响多项式因子 | |
| Church–Turing 论题 | 可计算 图灵机可计算 | 论题而非定理;强版本受随机、量子计算挑战 |
| P | 封闭、鲁棒,刻画「高效可解」 | |
| 通用图灵机 | 机器即串;区段缓冲使模拟开销降到 | |
| 不可计算性 | UC、HALT | 对角线法;归约的雏形;绝大多数函数不可计算 |
| Rice 定理 | 程序行为的非平凡性质 | 由 HALT 归约;静态分析只能近似 |
本章的两个工具贯穿此后的全部内容:对角线法用来证明「不存在」,归约用来比较难度。它们对可计算性给出了干净的答案;而对「多项式时间可计算」这一更精细的问题,下一章引入 NP 与 NP 完全性。课后习题「健忘图灵机」是 Cook–Levin 定理证明中的一步,其证明见Cook–Levin 定理。