TMSAT 说明 NP 完全问题存在,但它只是 NP 定义的改写。Cook–Levin 定理给出第一个「自然」的 NP 完全问题 SAT:图灵机的计算是局部 的,因而可以用一个多项式大小的公式逐步「检查」。此后证明新问题 NP 完全,只需从 SAT 或它的后代归约,不必再碰图灵机。
1. 布尔公式与 SAT# 1971 年前后,Cook 与 Levin 各自独立地提出 NP 完全性的概念,并给出了组合问题的例子;Karp(1972)随即说明 NP 完全性普遍存在,许多有实际意义的组合问题都是 NP 完全的。如今各学科中已有数千个问题被证明 NP 完全,而最简单的例子来自逻辑。
变量 u 1 , … , u n u_1,\dots,u_n u 1 , … , u n 布尔公式 由变量与逻辑运算 ∧ \wedge ∧ ∨ \vee ∨ ¬ \neg ¬ z ∈ { 0 , 1 } n z\in\{0,1\}^n z ∈ { 0 , 1 } n φ ( z ) \varphi(z) φ ( z ) z z z φ \varphi φ z z z φ ( z ) = 1 \varphi(z)=1 φ ( z ) = 1 φ \varphi φ 可满足 ,否则称其不可满足 。 例如 ( u 1 ∨ u 2 ) ∧ ( u 2 ∨ u 3 ) ∧ ( u 3 ∨ u 1 ) (u_1\vee u_2)\wedge(u_2\vee u_3)\wedge(u_3\vee u_1) ( u 1 ∨ u 2 ) ∧ ( u 2 ∨ u 3 ) ∧ ( u 3 ∨ u 1 ) u 1 , u 2 , u 3 u_1,u_2,u_3 u 1 , u 2 , u 3
文字 是变量 u k u_k u k u ˉ k \bar u_k u ˉ k 合取范式 (CNF),若它是若干子句 (文字的析取)的合取:
φ = ⋀ i ( ⋁ j v i j ) . \varphi=\bigwedge_i\Big(\bigvee_j v_{ij}\Big). φ = i ⋀ ( j ⋁ v ij ) . 若每个子句至多含 k k k k k k SAT 是全体可满足 CNF 公式构成的语言,3SAT 是全体可满足 3CNF 公式构成的语言。
SAT 与 3SAT 显然属于 NP:证书就是满足赋值,代入检查只需线性时间。
2. 定理与思路# SAT 是 NP 完全的; 3SAT 是 NP 完全的。 要把任意 L ∈ N P L\in\mathrm{NP} L ∈ NP x ↦ φ x x\mapsto\varphi_x x ↦ φ x x ∈ L ⟺ φ x x\in L\iff\varphi_x x ∈ L ⟺ φ x L L L M M M
x ∈ L ⟺ ∃ u ∈ { 0 , 1 } p ( ∣ x ∣ ) such that M ( x , u ) = 1. x\in L\iff\exists u\in\{0,1\}^{p(|x|)}\ \text{such that}\ M(x,u)=1. x ∈ L ⟺ ∃ u ∈ { 0 , 1 } p ( ∣ x ∣ ) such that M ( x , u ) = 1. 于是 φ x \varphi_x φ x u u u M M M
表达能力 :任何布尔函数都能写成 CNF(第 3 节),但一般需要指数大小,因此只能用于常数个变量 的函数;
局部性 :图灵机每一步只依赖常数个比特,但读写头的位置依赖于输入内容;借助健忘 图灵机(第 4 节)使位置与内容无关,每一步便只是常数个变量之间的约束(第 5 节)。
3. 工具一:CNF 的普适性# 对任意布尔函数 f : { 0 , 1 } l → { 0 , 1 } f:\{0,1\}^l\to\{0,1\} f : { 0 , 1 } l → { 0 , 1 } l l l l 2 l l2^l l 2 l φ \varphi φ u ∈ { 0 , 1 } l u\in\{0,1\}^l u ∈ { 0 , 1 } l φ ( u ) = f ( u ) \varphi(u)=f(u) φ ( u ) = f ( u ) ∧ / ∨ \wedge/\vee ∧ / ∨ 对每个 v ∈ { 0 , 1 } l v\in\{0,1\}^l v ∈ { 0 , 1 } l C v ( z 1 , … , z l ) C_v(z_1,\dots,z_l) C v ( z 1 , … , z l ) C v ( v ) = 0 C_v(v)=0 C v ( v ) = 0 u ≠ v u\ne v u = v C v ( u ) = 1 C_v(u)=1 C v ( u ) = 1 v i = 1 v_i=1 v i = 1 z ˉ i \bar z_i z ˉ i v i = 0 v_i=0 v i = 0 z i z_i z i C 010 = z 1 ∨ z ˉ 2 ∨ z 3 C_{010}=z_1\vee\bar z_2\vee z_3 C 010 = z 1 ∨ z ˉ 2 ∨ z 3
令 φ \varphi φ f ( v ) = 0 f(v)=0 f ( v ) = 0 C v C_v C v 2 l 2^l 2 l l 2 l l2^l l 2 l f ( u ) = 0 f(u)=0 f ( u ) = 0 C u C_u C u φ \varphi φ C u ( u ) = 0 C_u(u)=0 C u ( u ) = 0 φ ( u ) = 0 \varphi(u)=0 φ ( u ) = 0 f ( u ) = 1 f(u)=1 f ( u ) = 1 φ \varphi φ C v C_v C v v ≠ u v\ne u v = u C v ( u ) = 1 C_v(u)=1 C v ( u ) = 1 φ ( u ) = 1 \varphi(u)=1 φ ( u ) = 1 □ \square □
直接对 x ↦ M ( x , ⋅ ) x\mapsto M(x,\cdot) x ↦ M ( x , ⋅ ) p ( ∣ x ∣ ) 2 p ( ∣ x ∣ ) p(|x|)2^{p(|x|)} p ( ∣ x ∣ ) 2 p ( ∣ x ∣ ) l l l l 2 l l2^l l 2 l
例如异或 f ( z 1 , z 2 ) = z 1 ⊕ z 2 f(z_1,z_2)=z_1\oplus z_2 f ( z 1 , z 2 ) = z 1 ⊕ z 2 00 00 00 11 11 11 0 0 0 C 00 = z 1 ∨ z 2 C_{00}=z_1\vee z_2 C 00 = z 1 ∨ z 2 C 11 = z ˉ 1 ∨ z ˉ 2 C_{11}=\bar z_1\vee\bar z_2 C 11 = z ˉ 1 ∨ z ˉ 2 z 1 ⊕ z 2 = ( z 1 ∨ z 2 ) ∧ ( z ˉ 1 ∨ z ˉ 2 ) z_1\oplus z_2=(z_1\vee z_2)\wedge(\bar z_1\vee\bar z_2) z 1 ⊕ z 2 = ( z 1 ∨ z 2 ) ∧ ( z ˉ 1 ∨ z ˉ 2 ) 无法避免 :
l l l z 1 ⊕ ⋯ ⊕ z l z_1\oplus\cdots\oplus z_l z 1 ⊕ ⋯ ⊕ z l 2 l − 1 2^{l-1} 2 l − 1 设 φ \varphi φ C C C C C C z i z_i z i C C C v v v z i z_i z i v ′ v' v ′ C ( v ′ ) C(v') C ( v ′ ) v v v v ′ v' v ′ 1 1 1 φ \varphi φ 0 0 0 l l l 2 l − 1 2^{l-1} 2 l − 1 0 0 0 2 l − 1 2^{l-1} 2 l − 1 □ \square □ 所以不能指望把整个验证器一次写成 CNF,只能把它切成常数规模的小块。引入新变量 可以绕开这一障碍:用中间变量 s i s_i s i i i i s i = s i − 1 ⊕ z i s_i=s_{i-1}\oplus z_i s i = s i − 1 ⊕ z i 3 3 3 4 4 4 z i z_i z i
4. 工具二:健忘图灵机# 图灵机 M M M 健忘的 ,若对任意输入 x x x i ∈ N i\in\mathbb N i ∈ N M M M i i i ∣ x ∣ |x| ∣ x ∣ i i i x x x 任意图灵机 M M M M ′ M' M ′ M M M t t t M ′ M' M ′ O ( t 2 ) O(t^2) O ( t 2 ) 不妨设 M M M 鲁棒性 ,这只带来多项式开销)。令 M ′ M' M ′
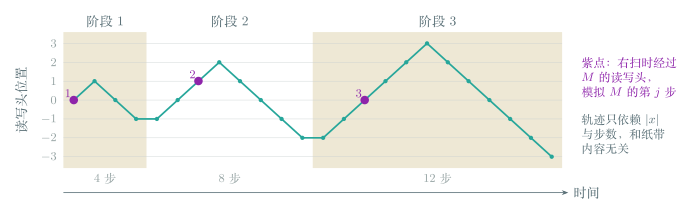
0 , 1 , 0 , − 1 , − 1 , 0 , 1 , 2 , 1 , 0 , − 1 , − 2 , ⋯ , − ( j − 1 ) , … , 0 , … , j , … , 0 , … , − j , ⋯ 0,1,0,-1,\quad -1,0,1,2,1,0,-1,-2,\quad\cdots,\quad -(j-1),\dots,0,\dots,j,\dots,0,\dots,-j,\quad\cdots 0 , 1 , 0 , − 1 , − 1 , 0 , 1 , 2 , 1 , 0 , − 1 , − 2 , ⋯ , − ( j − 1 ) , … , 0 , … , j , … , 0 , … , − j , ⋯ 第 j j j − ( j − 1 ) -(j-1) − ( j − 1 ) j j j − j -j − j 4 j 4j 4 j M M M j j j M M M t t t [ − ( t − 1 ) , t − 1 ] [-(t-1),t-1] [ − ( t − 1 ) , t − 1 ] M M M
具体地,在 M M M t t t M ′ M' M ′ − ( t − 1 ) -(t-1) − ( t − 1 ) t − 1 t-1 t − 1 M M M t t t
从左端标记向右扫,遇到 M M M M ′ M' M ′ q q q a a a δ ( q , a ) \delta(q,a) δ ( q , a ) M M M 继续右扫找到右端标记,将其右移一格; 回扫到左端标记,途中完成待办的左移,最后将左端标记左移一格。 无论输入如何,读写头轨迹都相同,故 M ′ M' M ′ t t t 4 ( 1 + 2 + ⋯ + t ) = O ( t 2 ) 4(1+2+\cdots+t)=O(t^2) 4 ( 1 + 2 + ⋯ + t ) = O ( t 2 ) M M M M ′ M' M ′ □ \square □
算法实现 \begin{algorithm}
\caption{Oblivious-Phase:健忘机 $M'$ 模拟 $M$ 的第 $t$ 步}
\begin{algorithmic}
\PROCEDURE{Phase}{$t$}
\COMMENT{进入时读写头位于左端标记 $-(t-1)$,状态中保存 $M$ 的当前状态 $q$}
\FOR{$i \gets -(t-1)$ \TO $t - 1$}
\IF{格 $i$ 带有 $M$ 的读写头标记}
\STATE 读出符号 $a$,$(q', b, d) \gets \delta(q, a)$,写入 $b$,$q \gets q'$
\STATE 在状态中记下移动方向 $d$ \COMMENT{右移在下一格完成,左移留待回程}
\ENDIF
\STATE 右移一格
\ENDFOR
\STATE 将右端标记移到格 $t$
\FOR{$i \gets t$ \DOWNTO $-(t-1)$}
\STATE 如有待办的左移,在相应位置完成;左移一格
\ENDFOR
\STATE 将左端标记移到格 $-t$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm} Fig 1 健忘机的之字形轨迹:第 j j j [ − j , j ] [-j,j] [ − j , j ] M M M j j j 上一章的课后习题(若 L ∈ D T I M E ( T ( n ) ) L\in\mathrm{DTIME}(T(n)) L ∈ DTIME ( T ( n )) O ( T ( n ) 2 ) O(T(n)^2) O ( T ( n ) 2 ) L L L O ( T log T ) O(T\log T) O ( T log T )
5. SAT 是 NP 完全的# 设 L ∈ N P L\in\mathrm{NP} L ∈ NP M M M p p p
M M M
M M M
这些变换只带来多项式的开销。记 Q Q Q M M M Γ \Gamma Γ T = T ( n ) T=T(n) T = T ( n ) M M M n + p ( n ) n+p(n) n + p ( n )
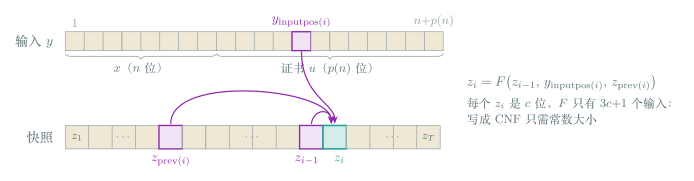
M M M y y y i i i 快照 是三元组 ⟨ a , b , q ⟩ ∈ Γ × Γ × Q \langle a,b,q\rangle\in\Gamma\times\Gamma\times Q ⟨ a , b , q ⟩ ∈ Γ × Γ × Q a , b a,b a , b q q q i i i c c c z i z_i z i c c c M M M 再定义两个函数:i n p u t p o s ( i ) \mathrm{inputpos}(i) inputpos ( i ) i i i p r e v ( i ) \mathrm{prev}(i) prev ( i ) i i i 最后一次 访问当前位置的步数(若此前从未访问,则约定读到空白符)。由于 M M M n + p ( n ) n+p(n) n + p ( n ) M M M i n p u t p o s ( i ) \mathrm{inputpos}(i) inputpos ( i ) p r e v ( i ) \mathrm{prev}(i) prev ( i )
Fig 2 快照的局部性:z i z_i z i 存在只依赖于 M M M F : { 0 , 1 } 2 c + 1 → { 0 , 1 } c F:\{0,1\}^{2c+1}\to\{0,1\}^c F : { 0 , 1 } 2 c + 1 → { 0 , 1 } c
z i = F ( z i − 1 , y i n p u t p o s ( i ) , z p r e v ( i ) ) . z_i=F\big(z_{i-1},\ y_{\mathrm{inputpos}(i)},\ z_{\mathrm{prev}(i)}\big). z i = F ( z i − 1 , y inputpos ( i ) , z prev ( i ) ) . 第 i i i q q q i − 1 i-1 i − 1 z i − 1 z_{i-1} z i − 1 y i n p u t p o s ( i ) y_{\mathrm{inputpos}(i)} y inputpos ( i ) p r e v ( i ) \mathrm{prev}(i) prev ( i ) z p r e v ( i ) z_{\mathrm{prev}(i)} z prev ( i ) □ \square □ (SAT 是 NP 难的 )快照序列完全决定了 M M M x ∈ L x\in L x ∈ L y ∈ { 0 , 1 } n + p ( n ) y\in\{0,1\}^{n+p(n)} y ∈ { 0 , 1 } n + p ( n ) z 1 , … , z T ∈ { 0 , 1 } c z_1,\dots,z_T\in\{0,1\}^c z 1 , … , z T ∈ { 0 , 1 } c
y y y n n n x x x z 1 z_1 z 1 M M M ⟨ ▹ , □ , q s t a r t ⟩ \langle\triangleright,\square,q_{\mathrm{start}}\rangle ⟨ ▹ , □ , q start ⟩ 对每个 i ∈ { 2 , … , T } i\in\{2,\dots,T\} i ∈ { 2 , … , T } z i = F ( z i − 1 , y i n p u t p o s ( i ) , z p r e v ( i ) ) z_i=F(z_{i-1},y_{\mathrm{inputpos}(i)},z_{\mathrm{prev}(i)}) z i = F ( z i − 1 , y inputpos ( i ) , z prev ( i ) ) z T z_T z T φ x \varphi_x φ x y ∈ { 0 , 1 } n + p ( n ) y\in\{0,1\}^{n+p(n)} y ∈ { 0 , 1 } n + p ( n ) z ∈ { 0 , 1 } c T z\in\{0,1\}^{cT} z ∈ { 0 , 1 } c T x ∈ L ⟺ φ x ∈ S A T x\in L\iff\varphi_x\in\mathrm{SAT} x ∈ L ⟺ φ x ∈ SAT y y y p ( n ) p(n) p ( n ) u u u
大小:条件 1 是 n n n 4 n 4n 4 n c c c c 2 c c2^c c 2 c T T T 3 c + 1 3c+1 3 c + 1 T ( 3 c + 1 ) 2 3 c + 1 T(3c+1)2^{3c+1} T ( 3 c + 1 ) 2 3 c + 1 d ( n + T ) d(n+T) d ( n + T ) d d d M M M i n p u t p o s , p r e v \mathrm{inputpos},\mathrm{prev} inputpos , prev φ x \varphi_x φ x M M M □ \square □
证明的要点在于:2 3 c + 1 2^{3c+1} 2 3 c + 1 c c c 常数 ;整个计算被切成 T T T
另一种写法:计算表格
不借助健忘机也能证明(Sipser 教材的写法)。设 M M M T T T T T T T + 1 T+1 T + 1 ( T + 1 ) × T (T+1)\times T ( T + 1 ) × T i + 1 i+1 i + 1 j j j i i i j − 1 , j , j + 1 j-1,j,j+1 j − 1 , j , j + 1 2 × 3 2\times3 2 × 3 O ( T 2 ) O(T^2) O ( T 2 ) O ( T 2 ) O(T^2) O ( T 2 )
两种写法的共同核心都是局部性 :表格写法把它体现为「空间上的邻居」,健忘机写法把它体现为「时间上的前驱」z i − 1 , z p r e v ( i ) z_{i-1},z_{\mathrm{prev}(i)} z i − 1 , z prev ( i ) O ( T log T ) O(T\log T) O ( T log T ) O ( T log T ) O(T\log T) O ( T log T ) Θ ( T 2 ) \Theta(T^2) Θ ( T 2 )
6. 3SAT 是 NP 完全的# S A T ≤ p 3 S A T \mathrm{SAT}\le_p\mathrm{3SAT} SAT ≤ p 3SAT 先看 4 个文字的子句,如 C = u 1 ∨ u ˉ 2 ∨ u ˉ 3 ∨ u 4 C=u_1\vee\bar u_2\vee\bar u_3\vee u_4 C = u 1 ∨ u ˉ 2 ∨ u ˉ 3 ∨ u 4 z z z C C C
C 1 = u 1 ∨ u ˉ 2 ∨ z , C 2 = u ˉ 3 ∨ u 4 ∨ z ˉ . C_1=u_1\vee\bar u_2\vee z,\qquad C_2=\bar u_3\vee u_4\vee\bar z. C 1 = u 1 ∨ u ˉ 2 ∨ z , C 2 = u ˉ 3 ∨ u 4 ∨ z ˉ . 若 C C C C 1 C_1 C 1 z = 0 z=0 z = 0 C 2 C_2 C 2 z = 1 z=1 z = 1 C C C C 1 C_1 C 1 z = 1 z=1 z = 1 C 2 C_2 C 2 z = 0 z=0 z = 0
一般地,含 k > 3 k>3 k > 3 C = ℓ 1 ∨ ⋯ ∨ ℓ k C=\ell_1\vee\cdots\vee\ell_k C = ℓ 1 ∨ ⋯ ∨ ℓ k k − 1 k-1 k − 1 C 1 = ℓ 1 ∨ ⋯ ∨ ℓ k − 2 ∨ z C_1=\ell_1\vee\cdots\vee\ell_{k-2}\vee z C 1 = ℓ 1 ∨ ⋯ ∨ ℓ k − 2 ∨ z 3 3 3 C 2 = ℓ k − 1 ∨ ℓ k ∨ z ˉ C_2=\ell_{k-1}\vee\ell_k\vee\bar z C 2 = ℓ k − 1 ∨ ℓ k ∨ z ˉ z z z k k k k − 2 k-2 k − 2
ℓ 1 ∨ ⋯ ∨ ℓ 5 ⟼ ( ℓ 1 ∨ ℓ 2 ∨ z 2 ) ∧ ( ℓ 3 ∨ z 1 ∨ z ˉ 2 ) ∧ ( ℓ 4 ∨ ℓ 5 ∨ z ˉ 1 ) . \ell_1\vee\cdots\vee\ell_5\ \longmapsto\ (\ell_1\vee\ell_2\vee z_2)\wedge(\ell_3\vee z_1\vee\bar z_2)\wedge(\ell_4\vee\ell_5\vee\bar z_1). ℓ 1 ∨ ⋯ ∨ ℓ 5 ⟼ ( ℓ 1 ∨ ℓ 2 ∨ z 2 ) ∧ ( ℓ 3 ∨ z 1 ∨ z ˉ 2 ) ∧ ( ℓ 4 ∨ ℓ 5 ∨ z ˉ 1 ) . 新变量像一条链:若真文字是 ℓ 3 \ell_3 ℓ 3 z 2 = 1 z_2=1 z 2 = 1 z 1 = 0 z_1=0 z 1 = 0 ℓ i \ell_i ℓ i z 2 = 1 z_2=1 z 2 = 1 z 1 = 1 z_1=1 z 1 = 1 □ \square □
算法实现 \begin{algorithm}
\caption{CNF-to-3CNF}
\begin{algorithmic}
\PROCEDURE{To3CNF}{$\varphi$}
\STATE $\psi \gets$ 空公式
\FORALL{$\varphi$ 中的子句 $C = \ell_1 \vee \cdots \vee \ell_k$}
\WHILE{$k > 3$}
\STATE 引入新变量 $z$
\STATE 将 $\ell_{k-1} \vee \ell_k \vee \bar z$ 加入 $\psi$
\STATE $C \gets \ell_1 \vee \cdots \vee \ell_{k-2} \vee z$,$k \gets k - 1$
\ENDWHILE
\STATE 将 $C$ 加入 $\psi$
\ENDFOR
\RETURN $\psi$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm} 由 SAT 的 NP 难性与传递性,3SAT 也是 NP 难的;它属于 NP,故是 NP 完全的。Cook–Levin 定理证毕。
2SAT 属于 P
子句长度从 3 降到 2,问题就变得容易。每个子句 a ∨ b a\vee b a ∨ b a ˉ → b \bar a\to b a ˉ → b b ˉ → a \bar b\to a b ˉ → a 2 n 2n 2 n 蕴含图 。可以证明:公式可满足当且仅当没有变量 u u u u u u u ˉ \bar u u ˉ O ( m + n ) O(m+n) O ( m + n ) 稳定匹配与图 )。上面的拆分之所以不能把 3 降为 2,是因为拆分 3 子句会得到一个 2 子句与另一个 3 子句,规模不降。
7. 再看 Cook–Levin 定理# 规模 :用 O ( T log T ) O(T\log T) O ( T log T ) φ x \varphi_x φ x O ( T log T ) O(T\log T) O ( T log T ) T T T M M M x x x
证书可以双向转换 :归约 f f f x ∈ L ⟺ f ( x ) ∈ S A T x\in L\iff f(x)\in\mathrm{SAT} x ∈ L ⟺ f ( x ) ∈ SAT x x x f ( x ) f(x) f ( x ) u u u z z z y y y p ( n ) p(n) p ( n )
若归约 f f f x x x f ( x ) f(x) f ( x ) f ( x ) f(x) f ( x ) x x x f f f Levin 归约 。 Levin 归约保证了「求解 SAT 的搜索版本」就足以求解任意 NP 问题的搜索版本,这将用于证明搜索与判定的等价性。
8. 第一个图论 NP 完全问题:独立集# I N D S E T = { ⟨ G , k ⟩ : ∃ S ⊆ V ( G ) , ∣ S ∣ = k , ∀ u , v ∈ S , ( u , v ) ∉ E ( G ) } \mathrm{INDSET}=\{\langle G,k\rangle:\exists S\subseteq V(G),\ |S|=k,\ \forall u,v\in S,\ (u,v)\notin E(G)\} INDSET = {⟨ G , k ⟩ : ∃ S ⊆ V ( G ) , ∣ S ∣ = k , ∀ u , v ∈ S , ( u , v ) ∈ / E ( G )} INDSET 属于 NP 已在上一章证明,下面给出 3 S A T ≤ p I N D S E T \mathrm{3SAT}\le_p\mathrm{INDSET} 3SAT ≤ p INDSET
设 φ \varphi φ n n n m m m 7 m 7m 7 m G G G
每个子句对应一个由 7 个顶点组成的簇 ,每个顶点对应该子句所含三个变量的一个满足此子句的部分赋值(三个变量共 2 3 = 8 2^3=8 2 3 = 8 同一簇内的任意两个顶点之间连边; 若两个顶点对应的部分赋值不相容 (对某个公共变量赋了不同的值),则在它们之间连边。 令 k = m k=m k = m G G G φ \varphi φ ⟺ \iff ⟺ G G G m m m
(⇒ \Rightarrow ⇒ u u u C C C u u u C C C C C C S S S S S S u u u S S S m m m
(⇐ \Leftarrow ⇐ S S S m m m S S S m m m i ∈ [ n ] i\in[n] i ∈ [ n ] S S S u i u_i u i a a a u i = a u_i=a u i = a u i u_i u i u u u u u u φ \varphi φ □ \square □
若某个子句只含 r < 3 r<3 r < 3 2 r − 1 2^r-1 2 r − 1 部件 (gadget)模拟原问题的局部结构(簇 = 子句的选择),一致性约束 (不相容边)把局部选择粘合成全局解。
三顶点版本
另一种常见构造(Kleinberg–Tardos):每个子句对应一个三角形,三个顶点分别对应子句的三个文字;再在每对互补文字 u i u_i u i u ˉ i \bar u_i u ˉ i k = m k=m k = m u i u_i u i u ˉ i \bar u_i u ˉ i
9. 小结# 结论 归约 关键 SAT 是 NP 完全的 任意 L ∈ N P ≤ p S A T L\in\mathrm{NP}\le_p\mathrm{SAT} L ∈ NP ≤ p SAT 健忘机 + 快照的局部性 + 常数变量函数的 CNF 3SAT 是 NP 完全的 S A T ≤ p 3 S A T \mathrm{SAT}\le_p\mathrm{3SAT} SAT ≤ p 3SAT 用新变量拆分长子句 INDSET 是 NP 完全的 3 S A T ≤ p I N D S E T \mathrm{3SAT}\le_p\mathrm{INDSET} 3SAT ≤ p INDSET 子句簇 + 不相容边
Cook–Levin 定理是唯一一次需要直接面对「任意 NP 语言」的证明:它的核心是计算的局部性 ,图灵机每一步只改动常数个比特,于是整个计算可以由多项式个常数规模的约束刻画。从此 SAT 取代了图灵机,成为证明 NP 完全性的起点;下一章沿归约链继续扩展,得到哈密顿路、集合覆盖、子集和等一大批 NP 完全问题,见NP 完全问题 。