分治是将多项式复杂度优化为更低的多项式复杂度的算法:分、治、合,其中合并与分治的复杂度存在竞争关系。
1. 引入:逆序对计数
求 $\tau[1..n]$ 中逆序对的个数。
逆序对上界是 $\Theta(n^2)$ 个,即暴力算法复杂度为 $O(n^2)$。算法至少要读入所有元素,所以理论下界为 $\Omega(n)$。
分治则考虑将问题转为子问题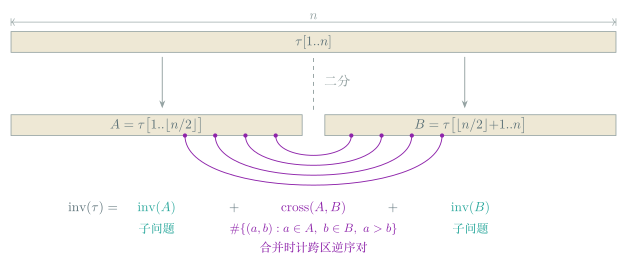
容易验证,如此计数方法没有重复和遗漏。不考虑二分的奇偶问题时,我们粗略地得到递推式
$$T(n)=2T(n/2)+f(n),$$其中 $T(n)$ 是统计总长为 $n$ 的数组中逆序数,同时完成排序的时间;$f(n)$ 是计算上述二分的两个有序数组之间的逆序数的时间(其实也包含二分生成子问题需要的时间,该部分应为 $\Theta(n)$)。鉴于合并是在两个已经排序的数组上进行的,所以用单指针扫描即可完成合并时的逆序对计数与排序操作,复杂度为 $f(n)=O(n)$。
算法实现
\begin{algorithm}
\caption{Sort-and-Count:统计逆序对并排序}
\begin{algorithmic}
\PROCEDURE{SortAndCount}{$L$}
  \IF{$|L| \le 1$}
    \RETURN $(0, L)$
  \ENDIF
  \STATE $A \gets$ 前 $\lfloor |L|/2 \rfloor$ 个元素,$B \gets$ 其余元素
  \STATE $(r_A, A) \gets$ \CALL{SortAndCount}{$A$}
  \STATE $(r_B, B) \gets$ \CALL{SortAndCount}{$B$}
  \STATE $(r, L') \gets$ \CALL{MergeAndCount}{$A, B$}
  \RETURN $(r_A + r_B + r,\ L')$
\ENDPROCEDURE
\PROCEDURE{MergeAndCount}{$A, B$}
  \STATE $i \gets 1,\ j \gets 1,\ r \gets 0$,$C \gets$ 空表
  \WHILE{$i \le |A|$ \AND $j \le |B|$}
    \IF{$A[i] \le B[j]$}
      \STATE 将 $A[i]$ 追加到 $C$,$i \gets i + 1$
    \ELSE
      \STATE $r \gets r + (|A| - i + 1)$ \COMMENT{$B[j]$ 小于 $A$ 中剩余的全部元素}
      \STATE 将 $B[j]$ 追加到 $C$,$j \gets j + 1$
    \ENDIF
  \ENDWHILE
  \STATE 将 $A$、$B$ 中剩余的元素依次追加到 $C$
  \RETURN $(r, C)$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
2. 主定理:分合权衡
从一般化参数出发,考虑一类问题
规模为 $n$ 的问题可以分成 $a$ 个规模为 $n/b$ 的子问题,分与合共花费 $f(n)$,则
$$T(n) = aT(n/b) + f(n).$$并且存在原子问题 $T(1)=c$。其中 $a\ge 1$,$b>1$,$c\ge 0$,$f(n)$ 是渐进正函数。
算法实现
\begin{algorithm}
\caption{分治的一般框架}
\begin{algorithmic}
\PROCEDURE{DivideAndConquer}{$P$}
  \IF{$|P| \le n_0$}
    \RETURN 直接求解 $P$ \COMMENT{原子问题,代价为常数}
  \ENDIF
  \STATE 将 $P$ 分为 $a$ 个规模为 $|P|/b$ 的子问题 $P_1, \dots, P_a$ \COMMENT{分}
  \FOR{$i \gets 1$ \TO $a$}
    \STATE $S_i \gets$ \CALL{DivideAndConquer}{$P_i$} \COMMENT{治}
  \ENDFOR
  \RETURN 由 $S_1, \dots, S_a$ 合并得到 $P$ 的解 \COMMENT{合;分与合共 $f(|P|)$}
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
直观来看,上述时间复杂度可以通过递归树来求解。以归并排序 $T(n)\leq 2T(n/2)+n, \ T(1)=0$ 为例:
递归树:第 $j$ 层有 $2^j$ 个规模为 $n/2^j$ 的子问题,该层分合用时 $n$,共 $\log_2 n$ 层,所以 $T(n)\leq n\log_2 n$;
归纳: 向后归纳是精确的:设 $T(n)\leq n\log_2 n$;向前归纳则需要取整。
若 $T(1)=0$,$T(n)\le T(\lceil n/2\rceil)+T(\lfloor n/2\rfloor)+n$,则 $T(n)\le n\lceil \log_2 n\rceil$。
对 $n$ 归纳。记 $n_1=\lfloor n/2\rfloor$,$n_2=\lceil n/2\rceil$。关键一步是
$$ \log _2n_2 = \log_2 \lceil n/2\rceil \le \log_2\left\lceil 2^{\lceil \log_2 n\rceil}/2\right\rceil = \log_22^{\lceil \log_2 n\rceil - 1}\leq \lceil \log_2 n\rceil - 1 .$$
待定系数:只猜解的形式,把常数和指数留到归纳中解出。
例如,对 $T(n)\le qT(n/2)+cn\ (q>2)$,猜测多项式上界并代入比较
$$T(n)\le kn^d\implies kn^d = qk(n/2)^d + cn = \frac{q}{2^d}kn^d + cn,$$直觉地认为 $d\geq 1$,否则 $cn$ 项会主导。于是为了统一主导项系数,解得 $d=\log_2 q$,再用更强的假设
$$T(n)\le kn^d-\ell n\implies kn^d-\ell n = q(k(n/2)^d-\ell n/2) + cn = \frac{q}{2^d}kn^d - \frac{q}{2}\ell n + cn,$$吸收 $cn$ 项,解得 $\ell = 2c/(q-2)$。
以上例子中,不难看出递推式的子问题复杂度和合并复杂度之间存在竞争关系。我们讨论不同的情形,给出刻画分治模型复杂度的主定理。将一般的递推式展开成递归树:第 $j$ 层有 $a^j$ 个规模为 $n/b^j$ 的子问题,共 $L=\log_b n$ 层,原子问题(叶子)的个数为 $a^{L}=n^{\log_b a}$,于是
$$ T(n)=\Theta\!\left(n^{\log_b a}\right)+\sum_{j=0}^{L-1}a^j f\!\left(n/b^j\right). $$前一项是全部原子问题的代价,由 $k=\log_b a$ 决定;后一项是合并代价,由 $f$ 决定。
设 $T(n)=aT(n/b)+f(n)$,$a\ge1$,$b>1$,$k=\log_b a$。
- 若 $f(n)=O(n^{k-\varepsilon})$(某常数 $\varepsilon>0$),则 $T(n)=\Theta(n^{k})$;
- 若 $f(n)=\Theta(n^{k}\log^p n)$($p\ge 0$),则 $T(n)=\Theta(n^{k}\log^{p+1} n)$;
- 若 $f(n)=\Omega(n^{k+\varepsilon})$,且存在常数 $c < 1$ 使 $af(n/b)\le cf(n)$ 对充分大的 $n$ 成立,则 $T(n)=\Theta(f(n))$。
不妨设 $n$ 为 $b$ 的幂,只需估计上式中的和式。关键在于 $a=b^k$,故 $a^j/(b^j)^k=1$。
情形 1:各层代价随深度几何递增,叶子主导。
$$ \sum_{j=0}^{L-1} a^j\!\left(\tfrac{n}{b^j}\right)^{k-\varepsilon} = n^{k-\varepsilon}\sum_{j=0}^{L-1} \left(b^{\varepsilon}\right)^j = n^{k-\varepsilon}\cdot\frac{b^{\varepsilon L}-1}{b^{\varepsilon}-1} = O\!\left(n^{k-\varepsilon}\cdot n^{\varepsilon}\right) = O(n^k), $$与叶子的 $\Theta(n^k)$ 合起来得 $\Theta(n^k)$。
情形 2:各层代价基本相同,总代价为每层代价乘以层数。
$$ \sum_{j=0}^{L-1} a^j\!\left(\tfrac{n}{b^j}\right)^{k}\log^p\!\tfrac{n}{b^j} = n^k\sum_{j=0}^{L-1}\left((L-j)\log b\right)^p = \Theta\!\left(n^k\sum_{m=1}^{L} m^p\right) = \Theta\!\left(n^k L^{p+1}\right). $$情形 3:反复应用正则性条件得 $a^jf(n/b^j)\le c^jf(n)$,各层代价几何递减,顶层主导。
$$ f(n)\le \sum_{j=0}^{L-1} a^j f(n/b^j) \le f(n)\sum_{j\ge0}c^j = \frac{f(n)}{1-c}, $$而叶子 $\Theta(n^k)=O(f(n))$,故 $T(n)=\Theta(f(n))$。
三种情形分别对应递归树中各层代价几何递增(叶子主导)、基本持平(每层相同,乘以层数)与几何递减(顶层主导);情形 3 中的正则性条件 $af(n/b)\le cf(n)$ 正是“逐层递减”的精确表述。
特别地,当 $f(n)=cn^d$ 时,第 $j$ 层代价为 $cn^d\,(a/b^d)^j$,只需比较公比 $a/b^d$ 与 $1$:
| 递推式 | 公比 | 情形 | 复杂度 |
|---|---|---|---|
| $T(n/2)+c$ | $1$($d=0$) | 2 | $\Theta(\log n)$ |
| $T(n/2)+cn$ | $1/2$ | 3 | $\Theta(n)$ |
| $2T(n/2)+cn$ | $1$ | 2 | $\Theta(n\log n)$ |
| $2T(n/2)+cn^2$ | $1/2$ | 3 | $\Theta(n^2)$,而非 $\Theta(n^2\log n)$ |
| $2T(n/2)+cn\log n$ | — | 2($p=1$) | $\Theta(n\log^2 n)$ |
| $qT(n/2)+cn$,$q>2$ | $q/2$ | 1 | $\Theta(n^{\log_2 q})$ |
据此,降低分治的复杂度有两条路径:
优化合并:情形 2、3 中 $f(n)$ 不处于劣势,压低 $f(n)$ 即可降低复杂度。逆序对计数利用有序性把合并降到 $O(n)$,正是如此;
优化分治:情形 1 中叶子主导,此时优化合并毫无用处,只能减少子问题的个数 $a$。
3. 优化合并:平面最近点对
给定平面上 $n$ 个点,求欧氏距离最近的一对点。
枚举所有点对,复杂度为 $\Theta(n^2)$;任何算法至少要读入全部点,下界为 $\Omega(n)$。一维情形下排序后比较相邻点即可,复杂度为 $O(n\log n)$;但在二维中,按某一坐标排序后,最近点对在序列中可能相隔很远。
分治则考虑用一条竖线 $L$ 按 $x$ 坐标将点集二分为左右两半。注意不能按四个象限划分,因为无法保证每块各有 $n/4$ 个点,子问题会失衡。分别递归求出两侧的最近距离 $\delta_1,\delta_2$,记 $\delta=\min(\delta_1,\delta_2)$,于是合并只需寻找跨越 $L$ 且距离小于 $\delta$ 的点对。
若 $q$ 在左侧、$r$ 在右侧且 $d(q,r) < \delta$,则 $q,r$ 都落在 $L$ 两侧宽 $2\delta$ 的带状区域内。
$|q_x-x_L|\le|q_x-r_x|\le d(q,r) < \delta$,$r$ 同理。
将带状区域内的点按 $y$ 坐标排序为 $s_1,s_2,\dots$。若 $|i-j|\ge 12$,则 $d(s_i,s_j)\ge\delta$。
将带状区域划分为边长 $\delta/2$ 的方格,每行 4 格。同一格内的两点位于 $L$ 的同侧,距离不超过 $\delta/\sqrt2 < \delta$,与 $\delta$ 的定义矛盾,故每格至多一个点,每行至多 4 个点。$s_i$ 与 $s_j$ 在排序中相隔至少 12 个位置,其间至少隔着 2 整行,于是 $|y_i-y_j|\ge 2\cdot\delta/2=\delta$。
更细致的论证可以将 12 改进为 7。由引理 2,合并时只需将带内每个点与其后 11 个点比较,这一步是 $O(n)$;合并的瓶颈在于“带内按 $y$ 排序”:
逐层排序:每层重新排序,$f(n)=O(n\log n)$,由主定理情形 2($p=1$)得 $T(n)=O(n\log^2 n)$;
预排序:递归前按 $x$、$y$ 各排序一次,每次递归返回按 $y$ 有序的点列,上层归并即可,$f(n)=O(n)$,由情形 2 得 $T(n)=O(n\log n)$。
二者分治方式完全相同,仅将合并从 $O(n\log n)$ 压到 $O(n)$,便省去了一个 $\log$ 因子。
算法实现
\begin{algorithm}
\caption{Closest-Pair:平面最近点对}
\begin{algorithmic}
\PROCEDURE{ClosestPair}{$P$}
  \STATE 将 $P$ 分别按 $x$、$y$ 坐标排序,得到 $P_x$、$P_y$ \COMMENT{$O(n\log n)$,只做一次}
  \RETURN \CALL{ClosestPairRec}{$P_x, P_y$}
\ENDPROCEDURE
\PROCEDURE{ClosestPairRec}{$P_x, P_y$}
  \IF{$|P_x| \le 3$}
    \RETURN 逐对计算距离得到的最近点对
  \ENDIF
  \STATE $Q \gets P_x$ 的前 $\lceil |P_x|/2 \rceil$ 个点,$R \gets$ 其余点
  \STATE 扫描 $P_x$、$P_y$ 各一遍,得到 $Q_x, Q_y, R_x, R_y$ \COMMENT{$O(n)$}
  \STATE $(q_0, q_1) \gets$ \CALL{ClosestPairRec}{$Q_x, Q_y$}
  \STATE $(r_0, r_1) \gets$ \CALL{ClosestPairRec}{$R_x, R_y$}
  \STATE $\delta \gets \min\{d(q_0, q_1),\ d(r_0, r_1)\}$
  \STATE $x^* \gets Q$ 中最大的 $x$ 坐标,$L$ 为直线 $x = x^*$
  \STATE $S_y \gets P_y$ 中到 $L$ 的距离小于 $\delta$ 的点,保持 $y$ 序 \COMMENT{$O(n)$}
  \FORALL{$s \in S_y$}
    \STATE 计算 $s$ 与 $S_y$ 中其后 11 个点的距离 \COMMENT{引理 2}
  \ENDFOR
  \STATE $(s, s') \gets$ 上述距离中最小的一对
  \IF{$d(s, s') < \delta$}
    \RETURN $(s, s')$
  \ELIF{$d(q_0, q_1) < d(r_0, r_1)$}
    \RETURN $(q_0, q_1)$
  \ELSE
    \RETURN $(r_0, r_1)$
  \ENDIF
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
4. 优化分治:整数乘法
给定两个 $n$ 位二进制整数 $x,y$,求 $xy$。
竖式乘法需要 $\Theta(n^2)$ 次位运算,Kolmogorov 曾猜想这是最优的;而读入输入至少需要 $\Omega(n)$。
分治则考虑将两数各自二分为高低两半。记 $m=\lceil n/2\rceil$,$x=2^m a+b$,$y=2^m c+d$,则
$$ xy=2^{2m}ac+2^m(bc+ad)+bd. $$直接递归计算 $ac,bc,ad,bd$ 四个乘积,移位与加法耗时 $\Theta(n)$,即 $T(n)=4T(n/2)+\Theta(n)$。此时 $k=\log_2 4=2$,属情形 1,$T(n)=\Theta(n^2)$:叶子主导,合并再快也无济于事,只能减少子问题的个数。
Karatsuba(1960)注意到,中间项可以由已有的两个乘积得到:
$$ bc+ad=ac+bd-(a-b)(c-d), $$于是只需 $ac$、$bd$、$(a-b)(c-d)$ 三次规模为 $n/2$ 的乘法:
$$ T(n)=3T(n/2)+\Theta(n)=\Theta\!\left(n^{\log_2 3}\right)=O(n^{1.585}). $$仍属情形 1,但指数由 $\log_2 4$ 降为 $\log_2 3$,从而推翻了 Kolmogorov 的猜想。
算法实现
\begin{algorithm}
\caption{Karatsuba-Multiply:整数乘法}
\begin{algorithmic}
\PROCEDURE{KaratsubaMultiply}{$x, y, n$}
  \IF{$n = 1$}
    \RETURN $x \times y$
  \ENDIF
  \STATE $m \gets \lceil n/2 \rceil$
  \STATE $a \gets \lfloor x / 2^m \rfloor,\ b \gets x \bmod 2^m$
  \STATE $c \gets \lfloor y / 2^m \rfloor,\ d \gets y \bmod 2^m$
  \STATE $e \gets$ \CALL{KaratsubaMultiply}{$a, c, m$}
  \STATE $f \gets$ \CALL{KaratsubaMultiply}{$b, d, m$}
  \STATE $g \gets$ \CALL{KaratsubaMultiply}{$a - b, c - d, m$} \COMMENT{差可能为负,单独记录符号}
  \RETURN $2^{2m} e + 2^m (e + f - g) + f$ \COMMENT{$bc + ad = e + f - g$}
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
后续进展
Toom–Cook 将数拆成 $r$ 段,只需 $2r-1$ 次乘法;Schönhage–Strassen 借助 FFT 做到 $O(n\log n\log\log n)$;2019 年 Harvey 与 van der Hoeven 最终给出 $O(n\log n)$。
5. 优化分治:矩阵乘法
给定两个 $n\times n$ 矩阵 $A,B$,求 $C=AB$。
按定义计算需要 $\Theta(n^3)$ 次算术运算;输出有 $n^2$ 个元素,下界为 $\Omega(n^2)$。
分治则考虑分块:将 $A,B,C$ 各分为四个 $\tfrac n2\times\tfrac n2$ 的块,$C_{ij}=A_{i1}B_{1j}+A_{i2}B_{2j}$,需要 8 次子矩阵乘法与 $\Theta(n^2)$ 的加法:
$$ T(n)=8T(n/2)+\Theta(n^2),\quad k=\log_2 8=3\implies T(n)=\Theta(n^3). $$与整数乘法如出一辙:属情形 1,合并的 $\Theta(n^2)$ 远非瓶颈。
$2\times 2$ 分块矩阵乘法只需 7 次子矩阵乘法:
$$
\begin{aligned}
P_1 &= A_{11}(B_{12}-B_{22}), & P_2 &= (A_{11}+A_{12})B_{22},\\
P_3 &= (A_{21}+A_{22})B_{11}, & P_4 &= A_{22}(B_{21}-B_{11}),\\
P_5 &= (A_{11}+A_{22})(B_{11}+B_{22}), & P_6 &= (A_{12}-A_{22})(B_{21}+B_{22}),\\
P_7 &= (A_{11}-A_{21})(B_{11}+B_{12}),
\end{aligned}
$$$$
C_{11}=P_5+P_4-P_2+P_6,\quad C_{12}=P_1+P_2,\quad C_{21}=P_3+P_4,\quad C_{22}=P_1+P_5-P_3-P_7 .
$$
逐项展开即可,例如 $C_{12}=A_{11}(B_{12}-B_{22})+(A_{11}+A_{12})B_{22}=A_{11}B_{12}+A_{12}B_{22}$。推导中只用到结合律与分配律,没有用到乘法交换律,因此对矩阵块同样成立,可以在每一层递归套用。$\square$
于是
$$ T(n)=7T(n/2)+\Theta(n^2)=\Theta\!\left(n^{\log_2 7}\right)=O(n^{2.81}). $$$n$ 不是 2 的幂时补零即可。由于 $2\times 2$ 矩阵乘法不可能只用 6 次乘法,进一步降低指数需要更大的分块或全新的方法。
算法实现
\begin{algorithm}
\caption{Strassen:矩阵乘法}
\begin{algorithmic}
\PROCEDURE{Strassen}{$A, B, n$}
  \IF{$n = 1$}
    \RETURN $A \cdot B$
  \ENDIF
  \STATE 将 $A$、$B$ 各分为四个 $\frac n2 \times \frac n2$ 的块 $A_{ij}$、$B_{ij}$
  \STATE $P_1 \gets$ \CALL{Strassen}{$A_{11},\ B_{12} - B_{22},\ \frac n2$}
  \STATE $P_2 \gets$ \CALL{Strassen}{$A_{11} + A_{12},\ B_{22},\ \frac n2$}
  \STATE $P_3 \gets$ \CALL{Strassen}{$A_{21} + A_{22},\ B_{11},\ \frac n2$}
  \STATE $P_4 \gets$ \CALL{Strassen}{$A_{22},\ B_{21} - B_{11},\ \frac n2$}
  \STATE $P_5 \gets$ \CALL{Strassen}{$A_{11} + A_{22},\ B_{11} + B_{22},\ \frac n2$}
  \STATE $P_6 \gets$ \CALL{Strassen}{$A_{12} - A_{22},\ B_{21} + B_{22},\ \frac n2$}
  \STATE $P_7 \gets$ \CALL{Strassen}{$A_{11} - A_{21},\ B_{11} + B_{12},\ \frac n2$}
  \STATE $C_{11} \gets P_5 + P_4 - P_2 + P_6,\ C_{12} \gets P_1 + P_2$
  \STATE $C_{21} \gets P_3 + P_4,\ C_{22} \gets P_1 + P_5 - P_3 - P_7$
  \RETURN 由四个块 $C_{ij}$ 拼成的矩阵 $C$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
6. 选点:卷积与 FFT
给定 $a=(a_0,\dots,a_{n-1})$,$b=(b_0,\dots,b_{n-1})$,求卷积 $c=a*b$,其中 $c_k=\sum_{i+j=k}a_ib_j$。
卷积即多项式乘积 $C(x)=A(x)B(x)$ 的系数,也刻画了信号平滑、两个独立随机变量之和的分布等。按定义计算需要 $\Theta(n^2)$;输入输出规模为 $\Theta(n)$,下界为 $\Omega(n)$。
多项式有两种表示,各有所长:
| 求值 | 相乘 | |
|---|---|---|
| 系数表示 | $O(n)$(Horner) | $O(n^2)$ |
| 点值表示 | $O(n^2)$(Lagrange) | $O(n)$(逐点相乘,需 $2n-1$ 个点) |
于是考虑在两种表示之间快速转换:系数 →(求值)→ 点值 →(逐点相乘)→ 点值 →(插值)→ 系数。逐点相乘只需 $O(n)$,瓶颈在于转换:求值即 Vandermonde 矩阵 $V_{jk}=x_j^k$ 乘向量,朴素需要 $\Theta(n^2)$;插值即求解线性方程组,Gauss 消元需要 $\Theta(n^3)$。分治能加速转换,关键在于选点。
分治则考虑按奇偶二分系数:
$$ A(x)=A_{\mathrm e}(x^2)+x\,A_{\mathrm o}(x^2),\qquad A(-x)=A_{\mathrm e}(x^2)-x\,A_{\mathrm o}(x^2). $$一对相反数 $\pm x$ 共享子问题,只需在 $x^2$ 处求两个次数减半的多项式。为使递归继续,平方后的点集仍须由相反数成对组成:$\pm1$ 平方后只剩 $1$,$\pm1,\pm i$ 平方后是 $\pm1$,这条链的终点就是单位根。
设 $n$ 为 2 的幂,$\omega=e^{2\pi i/n}$。由 $\omega^{k+n/2}=-\omega^k$,且 $\omega^{2k}$ 恰为 $n/2$ 次单位根,得到“蝶形”关系
$$ A(\omega^k)=A_{\mathrm e}(\omega^{2k})+\omega^kA_{\mathrm o}(\omega^{2k}),\qquad A(\omega^{k+n/2})=A_{\mathrm e}(\omega^{2k})-\omega^kA_{\mathrm o}(\omega^{2k}). $$故求值满足 $T(n)=2T(n/2)+O(n)$,由情形 2 得 $O(n\log n)$。插值同样可以化为求值:
$$ \sum_{s=0}^{n-1}\omega^{st}= \begin{cases} n, & n\mid t,\\ 0, & \text{否则},\end{cases} \qquad\text{从而}\qquad V^{-1}=\frac1n\,V(\omega^{-1}). $$
$\omega^t=1$ 时每一项都是 $1$;$\omega^t\ne1$ 时为等比级数 $\frac{\omega^{tn}-1}{\omega^t-1}=0$。于是 $\left(V\,\overline{V}\right)_{jk}=\sum_s\omega^{s(j-k)}=n\,[j=k]$。$\square$
即插值只是在 $\omega^{-1}$ 上再做一次 FFT 并除以 $n$。将两个向量补零到长度 $N\ge 2n-1$(取 2 的幂),三步合计 $O(n\log n)$。
算法实现
\begin{algorithm}
\caption{FFT 与卷积}
\begin{algorithmic}
\PROCEDURE{FFT}{$a_0, \dots, a_{n-1};\ \omega$}
  \COMMENT{$n$ 为 2 的幂,$\omega$ 为 $n$ 次本原单位根}
  \IF{$n = 1$}
    \RETURN $(a_0)$
  \ENDIF
  \STATE $(e_0, \dots, e_{n/2-1}) \gets$ \CALL{FFT}{$a_0, a_2, \dots, a_{n-2};\ \omega^2$}
  \STATE $(o_0, \dots, o_{n/2-1}) \gets$ \CALL{FFT}{$a_1, a_3, \dots, a_{n-1};\ \omega^2$}
  \FOR{$k \gets 0$ \TO $n/2 - 1$}
    \STATE $y_k \gets e_k + \omega^k o_k$
    \STATE $y_{k + n/2} \gets e_k - \omega^k o_k$ \COMMENT{蝶形}
  \ENDFOR
  \RETURN $(y_0, \dots, y_{n-1})$
\ENDPROCEDURE
\PROCEDURE{Convolution}{$a, b$}
  \STATE $N \gets$ 不小于 $2n - 1$ 的最小的 2 的幂,$\omega \gets e^{2\pi i/N}$
  \STATE 将 $a$、$b$ 补零到长度 $N$
  \STATE $\hat a \gets$ \CALL{FFT}{$a;\ \omega$},$\hat b \gets$ \CALL{FFT}{$b;\ \omega$} \COMMENT{求值}
  \FOR{$k \gets 0$ \TO $N - 1$}
    \STATE $\hat c_k \gets \hat a_k \hat b_k$ \COMMENT{逐点相乘}
  \ENDFOR
  \STATE $c \gets \frac1N\,$\CALL{FFT}{$\hat c;\ \omega^{-1}$} \COMMENT{插值}
  \RETURN $(c_0, \dots, c_{2n-2})$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
7. 两个小例子
单峰数组:$A[1..n]$ 先严格递增、后严格递减,求峰值的位置,要求读取尽可能少的元素。
取 $m=\lfloor n/2\rfloor$,读 $A[m-1],A[m],A[m+1]$:处于上坡则峰值在右半,处于下坡则在左半,比两侧都大则 $m$ 即为峰值。每次读常数个元素并丢弃一半,$T(n)=T(n/2)+O(1)$,由情形 2 得 $O(\log n)$。一般地,只要每层花费常数、并丢弃常数比例的输入,复杂度就是 $O(\log n)$。$\square$
算法实现
\begin{algorithm}
\caption{Find-Peak:单峰数组找峰值}
\begin{algorithmic}
\PROCEDURE{FindPeak}{$A[1..n]$}
  \COMMENT{约定 $A[0] = A[n+1] = -\infty$;不变量:峰值位于 $[l, r]$}
  \STATE $l \gets 1,\ r \gets n$
  \WHILE{\TRUE}
    \STATE $m \gets \lfloor (l + r)/2 \rfloor$
    \IF{$A[m-1] < A[m]$ \AND $A[m] > A[m+1]$}
      \RETURN $m$
    \ELIF{$A[m-1] < A[m]$}
      \STATE $l \gets m + 1$ \COMMENT{上坡:峰值在右侧}
    \ELSE
      \STATE $r \gets m - 1$ \COMMENT{下坡:峰值在左侧}
    \ENDIF
  \ENDWHILE
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}一次买卖:已知第 $1,\dots,n$ 天的股价 $p(1),\dots,p(n)$,求 $i < j$ 使 $p(j)-p(i)$ 最大。
最优解要么完全在前半,要么完全在后半,要么跨越中点;跨越中点时,最优解即前半的最低价与后半的最高价,可在 $O(n)$ 内求出。于是 $T(n)=2T(n/2)+O(n)=O(n\log n)$。(维护前缀最小值的动态规划可做到 $O(n)$。)$\square$
算法实现
\begin{algorithm}
\caption{Max-Profit:一次买卖的最大收益}
\begin{algorithmic}
\PROCEDURE{MaxProfit}{$p, l, r$}
  \IF{$l = r$}
    \RETURN $0$ \COMMENT{只有一天,无法获利}
  \ENDIF
  \STATE $m \gets \lfloor (l + r)/2 \rfloor$
  \STATE $g_1 \gets$ \CALL{MaxProfit}{$p, l, m$}
  \STATE $g_2 \gets$ \CALL{MaxProfit}{$p, m + 1, r$}
  \STATE $g_3 \gets \max_{m < j \le r} p(j) - \min_{l \le i \le m} p(i)$ \COMMENT{跨越中点,$O(n)$}
  \RETURN $\max\{g_1, g_2, g_3\}$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
8. 小结
| 问题 | 递推式 | 主定理情形 | 优化方向 | 关键 |
|---|---|---|---|---|
| 逆序对计数 | $2T(n/2)+O(n)$ | 2 | 合并 | 递归返回有序序列,使合并线性 |
| 最近点对 | $2T(n/2)+O(n)$ | 2 | 合并 | 带状区域与方格引理;预排序把 $f$ 从 $n\log n$ 压到 $n$ |
| 整数乘法 | $3T(n/2)+O(n)$ | 1 | 分治 | 4 次乘法降为 3 次 |
| 矩阵乘法 | $7T(n/2)+O(n^2)$ | 1 | 分治 | 8 次乘法降为 7 次 |
| 卷积(FFT) | $2T(n/2)+O(n)$ | 2 | 选点 | 单位根使 $\pm x$ 共享子问题;正交性使插值也是 FFT |
分治的分析与设计,都可以归结为分与合的竞争:先写出递推式,判断叶子与合并谁占主导,再决定从哪一端优化。叶子主导时减少子问题个数,合并不处于劣势时压低合并代价;同时要保证子问题规模均衡,否则递推式本身便不成立。
9. 补充:子问题的平衡
小结中提到子问题规模须均衡,这里说明它的确切含义。
若每次把规模为 $n$ 的问题分成规模为 $\alpha n$ 与 $(1-\alpha)n$ 的两个子问题($0<\alpha\le 1/2$),合并代价为 $cn$,即
$$T(n)=T(\alpha n)+T((1-\alpha)n)+cn,$$不平衡的划分会损失多少?
主定理要求子问题等长,不能直接使用,仍从递归树出发。同一层的子问题互不相交,规模之和不超过 $n$,故每层代价不超过 $cn$;变化的只是树的形状:沿较大的一侧下降最深,沿较小的一侧最浅。
对任意常数 $0<\alpha\le 1/2$,忽略取整与低阶项,
$$cn\log_{1/\alpha}n\ \le\ T(n)\ \le\ cn\log_{1/(1-\alpha)}n,$$从而 $T(n)=\Theta(n\log n)$。
最深的叶子沿每次取较大一侧到达,深度为 $\log_{1/(1-\alpha)}n$;最浅的叶子沿较小一侧到达,深度为 $\log_{1/\alpha}n$。最浅叶子之上的每一层都是满的,规模之和恰为 $n$,代价为 $cn$;其下各层的代价不超过 $cn$。层数与每层代价相乘即得上下界,而 $\log_{1/\alpha}n$ 与 $\log_{1/(1-\alpha)}n$ 都是 $\Theta(\log n)$。$\square$
更精确地,$T(n)\sim cn\log_2 n/H(\alpha)$,其中 $H(\alpha)=-\alpha\log_2\alpha-(1-\alpha)\log_2(1-\alpha)$ 为二元熵:对半划分时 $H=1$;按 $1:9$ 划分时 $1/H\approx 2.13$,只慢约一倍。但若划分退化为 $n-1$ 与 $1$,则
$$ T(n)=T(n-1)+T(1)+cn=\Theta(n^2), $$递归树退化为一条长为 $n$ 的链,这正是快速排序的最坏情形。由此:
平衡的含义:最大的子问题不超过 $n$ 的某个常数比例,使递归树高为 $O(\log n)$;比例本身只影响常数;
平衡的保证:划分点取决于输入时(如快速排序的主元),可以用线性时间的中位数选择保证比例,或用随机化使划分在期望意义下平衡。
Akra–Bazzi 定理
主定理在子问题不等长时的推广:设 $T(n)=\sum_{i=1}^m a_iT(b_in)+f(n)$,$a_i>0$,$0 < b_i < 1$,取 $p$ 使 $\sum_i a_ib_i^p=1$,则
$$T(n)=\Theta\!\left(n^p\left(1+\int_1^n\frac{f(u)}{u^{p+1}}\,\mathrm du\right)\right).$$对上面的递推式,$\alpha+(1-\alpha)=1$ 给出 $p=1$,$\int_1^n \frac{cu}{u^2}\,\mathrm du=c\ln n$,故 $T(n)=\Theta(n\log n)$;子问题等长时,它退化为主定理。
递归树本身就是一棵树:线性合并时总代价约为每层代价乘以树高,平衡划分正是为了使树高为 $O(\log n)$。搜索树与此完全相同——查找的代价就是树高,二分查找 $T(n)=T(n/2)+O(1)$ 正是沿一棵平衡二叉搜索树向下走一条路径。分叉数 $k$ 如何影响搜索效率、动态插入删除时如何维持平衡,见平衡 k 叉树与搜索效率。