贪心是按某个局部准则逐步构造解、且从不反悔的算法:设计贪心很容易,难的是证明。同一个问题往往有多个看似合理的准则,只有能与任意最优解比较而不落下风的那一个才是正确的。
1. 引入:区间调度
给定 $n$ 个任务,任务 $j$ 占据时间区间 $[s_j,f_j)$;两个任务相容当且仅当区间不相交。求两两相容的任务子集的最大规模。
枚举全部 $2^n$ 个子集并逐一检查相容性,复杂度是指数级的;算法至少要读入所有区间,下界为 $\Omega(n)$。
贪心则考虑按某种自然的顺序逐个考察任务,与已选任务相容就选上。顺序有多种候选:
最早开始:按 $s_j$ 升序;最短区间:按 $f_j-s_j$ 升序;最少冲突:按与之冲突的任务数 $c_j$ 升序;最早结束:按 $f_j$ 升序。
前三种都有反例:
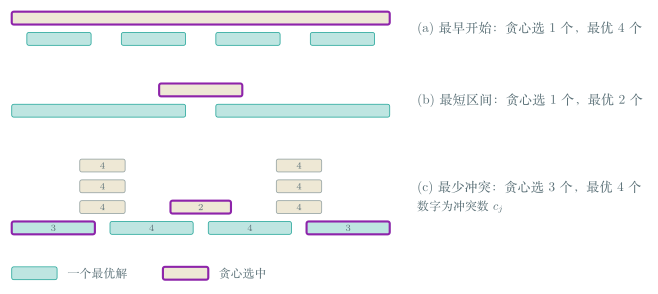
最早结束的直觉是:先选的任务结束得越早,留给其余任务的时间就越多。实现时只需记住最后选入的任务 $j^*$,任务 $k$ 与已选集合相容当且仅当 $s_k\ge f_{j^*}$,每次检查 $O(1)$,瓶颈在排序,共 $O(n\log n)$。
算法实现
\begin{algorithm}
\caption{Earliest-Finish-Time-First:区间调度}
\begin{algorithmic}
\PROCEDURE{IntervalScheduling}{$s_1, \dots, s_n;\ f_1, \dots, f_n$}
  \STATE 将任务按结束时间排序,使 $f_1 \le f_2 \le \dots \le f_n$ \COMMENT{$O(n\log n)$}
  \STATE $A \gets \emptyset$,$t \gets -\infty$ \COMMENT{$t$:最后选入的任务的结束时间}
  \FOR{$j \gets 1$ \TO $n$}
    \IF{$s_j \ge t$}
      \STATE $A \gets A \cup \{j\}$,$t \gets f_j$
    \ENDIF
  \ENDFOR
  \RETURN $A$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
证明的思路是:贪心每一步都“不落后”于任何其它解。
设贪心依次选出 $i_1,\dots,i_k$,$j_1,\dots,j_m$ 是任意一个相容解,二者都按结束时间排序。则对一切 $r\le\min(k,m)$,有 $f_{i_r}\le f_{j_r}$。
对 $r$ 归纳。$r=1$ 时贪心选的是全局最早结束的任务。设 $f_{i_{r-1}}\le f_{j_{r-1}}$,由于 $j_{r-1}$ 与 $j_r$ 相容,
$$f_{i_{r-1}}\le f_{j_{r-1}}\le s_{j_r},$$即 $j_r$ 与贪心的前 $r-1$ 个选择都相容,是贪心选第 $r$ 个任务时的候选之一;贪心在候选中取结束最早的,故 $f_{i_r}\le f_{j_r}$。$\square$
最早结束优先的贪心算法给出区间调度的最优解。
设最优解 $j_1,\dots,j_m$ 满足 $m>k$。由引理 $f_{i_k}\le f_{j_k}\le s_{j_{k+1}}$,即 $j_{k+1}$ 与贪心的全部选择相容,贪心不会在 $i_k$ 之后停下,矛盾。$\square$
2. 贪心的框架:三种论证
从区间调度出发,贪心算法大多具有如下形式:
算法实现
\begin{algorithm}
\caption{贪心的一般框架}
\begin{algorithmic}
\PROCEDURE{Greedy}{$E$}
  \STATE 按某个关键字将 $E$ 排序 \COMMENT{准则}
  \STATE $A \gets \emptyset$
  \FORALL{$e \in E$,按上述顺序}
    \IF{$A \cup \{e\}$ 可行}
      \STATE $A \gets A \cup \{e\}$ \COMMENT{一旦做出,永不撤销}
    \ENDIF
  \ENDFOR
  \RETURN $A$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
设计只需决定两件事:按什么排序,如何快速检查可行性。复杂度通常由排序与可行性检查的数据结构决定,难点全在正确性:贪心不回溯,正确性不能靠搜索保证,只能证明贪心解不劣于任意一个最优解 $O$。从分治的角度看,贪心是每一步只留下一个子问题的分治:做出一个选择后,剩下的问题与原问题同型(最优子结构),而这个选择可以出现在某个最优解中(贪心选择性质)。证明后者的基本手段有三种:
领先(greedy stays ahead):为部分解定义一个度量,归纳证明贪心的前 $r$ 步不落后于 $O$ 的前 $r$ 步,于是终点也不落后。区间调度、Dijkstra 都是如此;
交换(exchange argument):把 $O$ 逐步变换为贪心解,每一步都不使目标变差。最小化延迟、最优缓存、最小生成树都是如此;
结构下界(structural bound):找出任何可行解都必须付出的代价,再证明贪心恰好达到它。区间划分、聚类都是如此。
交换论证有一个常用的标准形式。称解中“违背贪心顺序的一对元素”为逆序,贪心解是没有逆序的解。
若(1)所有无逆序的解目标值相同;(2)任何有逆序的解都能通过一次交换,使逆序数严格减少而目标值不变差,则贪心解是最优的。
在所有最优解中取逆序数最少的 $O$。若 $O$ 有逆序,由(2)交换后仍为最优解且逆序更少,与 $O$ 的选取矛盾;故 $O$ 无逆序,由(1)与贪心解的目标值相同。$\square$
此外,设计贪心的第一步往往是找反例:Fig 1 用三个小例子淘汰了三条准则,剩下的那条才值得证明。
3. 结构下界:区间划分
给定 $n$ 节课,第 $j$ 节课占据 $[s_j,f_j)$。将所有课安排进教室,使同一教室中的课两两不相交,求所需教室数的最小值。
与区间调度不同,这里每个区间都必须安排。先给出任何方案都必须满足的下界:
区间集合的深度是同一时刻被覆盖的区间个数的最大值。
显然教室数 $\ge$ 深度:深度为 $d$ 的时刻有 $d$ 节课同时进行,它们必须在不同教室。贪心则考虑按开始时间排序,每节课放入任一空闲教室,没有空闲教室时才新开一间。用最小堆维护各教室最后一节课的结束时间,检查“是否有空闲教室”只需比较 $s_j$ 与堆顶,共 $O(n\log n)$。
算法实现
\begin{algorithm}
\caption{Earliest-Start-Time-First:区间划分}
\begin{algorithmic}
\PROCEDURE{IntervalPartitioning}{$s_1, \dots, s_n;\ f_1, \dots, f_n$}
  \STATE 将课程按开始时间排序,使 $s_1 \le s_2 \le \dots \le s_n$
  \STATE $d \gets 0$,$Q \gets$ 空的最小堆 \COMMENT{键:教室中最后一节课的结束时间}
  \FOR{$j \gets 1$ \TO $n$}
    \IF{$Q$ 非空 \AND $\min Q \le s_j$}
      \STATE $k \gets$ \CALL{ExtractMin}{$Q$} \COMMENT{教室 $k$ 已空闲}
    \ELSE
      \STATE $d \gets d + 1$,$k \gets d$ \COMMENT{新开一间教室}
    \ENDIF
    \STATE 将课程 $j$ 安排在教室 $k$,\CALL{Insert}{$Q, k, f_j$}
  \ENDFOR
  \RETURN 安排方案(共 $d$ 间教室)
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
上述贪心使用的教室数恰为深度,因而是最优的。
贪心从不把冲突的课放进同一教室,故方案可行。设贪心共开了 $d$ 间教室,第 $d$ 间是为课程 $j$ 开的:此时其余 $d-1$ 间教室都不空闲,各有一节课在 $s_j$ 之后才结束;由于按开始时间排序,这些课都在 $s_j$ 之前(或同时)开始。于是连同 $j$,共 $d$ 节课覆盖时刻 $s_j$,深度 $\ge d$。而任何方案都至少需要深度那么多教室。$\square$
这里的证明不比较贪心与最优解的每一步,而是让贪心“自证”:它新开教室的那一刻,恰好找到了一个所有方案都绕不过去的瓶颈。
4. 交换论证:最小化最大延迟
单台机器依次处理 $n$ 个任务,任务 $j$ 需要 $t_j$ 的处理时间,截止时间为 $d_j$。若 $j$ 在 $s_j$ 开始,则在 $f_j=s_j+t_j$ 完成,延迟为 $\ell_j=\max\{0,f_j-d_j\}$。求使最大延迟 $L=\max_j\ell_j$ 最小的顺序。
枚举所有 $n!$ 种顺序是不现实的。候选准则及其反例:
最短处理时间:$t=(1,10)$,$d=(100,10)$,先做任务 1 使任务 2 延迟 $1$,反过来则无延迟;
最小松弛 $d_j-t_j$:$t=(1,10)$,$d=(2,10)$,松弛为 $1,0$,先做任务 2 使任务 1 延迟 $9$,反过来最大延迟只有 $1$;
最早截止:按 $d_j$ 升序依次处理,不留空闲。
最早截止完全忽略处理时间,看上去有些可疑,但它是正确的。
算法实现
\begin{algorithm}
\caption{Earliest-Deadline-First:最小化最大延迟}
\begin{algorithmic}
\PROCEDURE{EDF}{$t_1, \dots, t_n;\ d_1, \dots, d_n$}
  \STATE 将任务按截止时间排序,使 $d_1 \le d_2 \le \dots \le d_n$
  \STATE $t \gets 0$
  \FOR{$j \gets 1$ \TO $n$}
    \STATE $s_j \gets t$,$f_j \gets t + t_j$,$t \gets f_j$ \COMMENT{紧接着上一个任务,无空闲}
  \ENDFOR
  \RETURN 区间 $[s_1, f_1], \dots, [s_n, f_n]$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
显然存在无空闲的最优解(把空闲压缩掉不会增加任何延迟),EDF 也无空闲。按交换论证的标准形式,称一对任务 $i,j$ 为逆序,若 $d_i < d_j$ 但 $j$ 排在 $i$ 之前,这与分治中计数的逆序对是同一概念。EDF 没有逆序。
(1)无逆序、无空闲的方案最大延迟都相同;(2)有逆序的无空闲方案中,必有一对相邻的逆序任务;(3)交换一对相邻的逆序任务,逆序数恰好减少 $1$,且最大延迟不增加。
(1)无逆序的方案之间只差在截止时间相同的任务的次序;这些任务连续排列,占据同一段时间,其中延迟最大的是最后一个完成的,它的完成时间与截止时间都不依赖于内部次序。
(2)若没有相邻的逆序,则沿着排列截止时间单调不减,整个方案无逆序。
(3)设 $j$ 紧排在 $i$ 之前且 $d_i < d_j$。交换后其余任务的完成时间不变;$i$ 提前完成,$\ell_i'\le\ell_i$;$j$ 现在恰好在原先 $i$ 的完成时刻 $f_i$ 完成,于是
$$\ell_j'=\max\{0,f_i-d_j\}\le\max\{0,f_i-d_i\}=\ell_i.$$故交换后 $\max\{\ell_i',\ell_j'\}\le\ell_i$。只有 $(i,j)$ 这一对的相对次序改变,逆序数减少 $1$。$\square$
EDF 给出的方案使最大延迟最小。
只需在无空闲的方案中比较。由引理(2)(3),交换论证的条件(2)成立;由引理(1),条件(1)成立。故 EDF 最优。$\square$
5. 更复杂的交换:最优缓存
缓存可容纳 $k$ 个数据项,初始已满。依次到来请求 $d_1,\dots,d_m$:请求的项在缓存中则命中;否则缺失,必须把它调入缓存,并驱逐一个已有的项。求使驱逐次数最少的驱逐方案。
例如 $k=2$,初始缓存为 $\{a,b\}$,请求序列 $a,b,c,b,c,a,a,b$,最优方案驱逐 $2$ 次。这是离线问题,整个请求序列预先已知。候选准则有 LIFO、FIFO、LRU(最久未使用)、LFU(最少使用),以及 Bélády 的 最远将来(Farthest-in-Future, FF):驱逐缓存中下一次被请求的时刻最晚的项。FF 的直觉很自然,证明却比上一节精细:交换一次驱逐决策后,两个方案的缓存不再相同,后续行为无法直接照搬。
算法实现
\begin{algorithm}
\caption{Farthest-in-Future:离线最优缓存}
\begin{algorithmic}
\PROCEDURE{FarthestInFuture}{$d_1, \dots, d_m;\ C$}
  \COMMENT{$C$:初始缓存,$|C| = k$}
  \STATE $r \gets 0$
  \FOR{$i \gets 1$ \TO $m$}
    \IF{$d_i \notin C$}
      \STATE $e \gets C$ 中下一次请求时刻($i$ 之后,没有则为 $\infty$)最晚的项
      \STATE $C \gets C - \{e\} \cup \{d_i\}$,$r \gets r + 1$
    \ENDIF
  \ENDFOR
  \RETURN $r$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
预先倒序扫描一遍求出每个位置的“下一次请求时刻”,再用堆维护缓存中各项的这一时刻,共 $O(m\log k)$。
先排除一种干扰。一般的方案可以在某项未被请求时就把它调入缓存;称只在请求到某项且该项缺失时才调入它的方案为约化的。
任何方案 $S$ 都可以变为约化方案 $\bar S$,且调入次数不增加。
$S$ 在未被请求时调入 $d$ 的地方,$\bar S$ 只是“假装”调入,把真正的调入推迟到下一次请求 $d$ 的时刻;若在此之前 $S$ 又把 $d$ 驱逐了,这次调入就整个省去。$\bar S$ 的每次调入都能对应到 $S$ 的一次更早的调入。$\square$
对约化方案,调入次数恰好等于缺失次数。于是只需在约化方案中比较。
设约化方案 $S$ 在前 $j$ 个请求上与 $S_{FF}$ 的驱逐决策相同,则存在约化方案 $S'$ 在前 $j+1$ 个请求上与 $S_{FF}$ 相同,且驱逐次数不超过 $S$。
两者在第 $j+1$ 个请求 $d=d_{j+1}$ 之前缓存相同。若 $d$ 命中,或两者驱逐同一项,取 $S'=S$ 即可。否则 $S_{FF}$ 驱逐 $e$,而 $S$ 驱逐 $f\ne e$。令 $S'$ 在此处驱逐 $e$,此后两者的缓存只差一项:$S'$ 有 $f$,$S$ 有 $e$。从 $j+2$ 起让 $S'$ 照搬 $S$,直到首次出现以下情形之一:
- 请求某个 $g\ne e,f$,$g$ 缺失且 $S$ 驱逐 $e$:令 $S'$ 驱逐 $f$,两者缓存从此相同;
- 请求 $f$,$S$ 驱逐某项 $e'$:若 $e'=e$,$S'$ 直接命中 $f$,缓存相同且 $S'$ 少一次驱逐;若 $e'\ne e$,令 $S'$ 驱逐 $e'$ 并调入 $e$,缓存相同,但 $S'$ 不再是约化的,用上一引理将其约化,驱逐次数不增加。
此后 $S'$ 完全照搬 $S$;若两种情形都不发生,$S'$ 一直照搬 $S$ 即可。关键在于不会先出现对 $e$ 的请求(那时 $S$ 命中而 $S'$ 缺失):FF 在第 $j+1$ 步驱逐的 $e$ 是缓存中下一次被请求最晚的,所以在 $e$ 被请求之前,$f$ 一定先被请求,第二种情形先于它发生。$\square$
FF 的驱逐次数不超过任何方案,因而是最优的。
从任一最优方案出发,先约化,再对 $j=0,1,\dots,m-1$ 反复应用上一引理,得到的方案与 $S_{FF}$ 处处相同,而驱逐次数从未增加。$\square$
在线缓存
现实中请求序列事先未知,是在线问题。LRU 是 FF 在时间方向上的镜像(驱逐最久之前使用的,而非最久之后使用的),借助访问的局部性在实践中表现很好;Sleator 与 Tarjan 证明它是 $k$-竞争的,即缺失次数不超过 FF 的 $k$ 倍(再加常数)。LIFO 则可以任意差:交替请求两个项,其中一个总是刚被调入又被驱逐。
6. 领先:最短路
给定有向图 $G=(V,E)$,$|V|=n$,$|E|=m$,边长 $\ell_e\ge 0$,以及源点 $s$。求 $s$ 到每个节点的最短路长度。
枚举所有路径是指数级的;算法至少要读入所有边,下界为 $\Omega(m+n)$。边长全为 $1$ 时,BFS 按层(跳数)向外扩展即可在 $O(m+n)$ 内解决,见算法设计:稳定匹配与图;一般边长下,贪心则考虑按距离而非层数向外扩展。
Dijkstra 维护已确定最短距离的集合 $S$,初始 $S=\{s\}$,$d(s)=0$。每一步选出 $S$ 外使
$$ \pi(v)=\min_{e=(u,v),\ u\in S} d(u)+\ell_e $$最小的节点 $v$,将其加入 $S$ 并令 $d(v)=\pi(v)$。
对任意时刻的 $S$ 及每个 $u\in S$,$d(u)$ 是 $s$ 到 $u$ 的最短路长度。
对 $|S|$ 归纳,$|S|=1$ 显然。设下一个加入的是 $v$,$(u,v)$ 是取到 $\pi(v)$ 的边,则 $s\to u$ 的最短路接上 $(u,v)$ 是一条长为 $\pi(v)$ 的路。
任取一条 $s\to v$ 的路 $P$。它从 $S$ 中出发而终点不在 $S$ 中,必有第一条离开 $S$ 的边 $(x,y)$,记 $P'$ 为 $P$ 中 $s\to x$ 的部分。由归纳假设 $\ell(P')\ge d(x)$,由边长非负,
$$ \ell(P)\ \ge\ \ell(P')+\ell_{(x,y)}\ \ge\ d(x)+\ell_{(x,y)}\ \ge\ \pi(y)\ \ge\ \pi(v), $$最后一步因为 Dijkstra 选的是 $\pi$ 最小的节点。故 $P$ 不短于 $\pi(v)$。$\square$
这是领先论证:任何路径一旦离开 $S$,长度就已不小于 $\pi(v)$,此后只会更长。“只会更长”正是边长非负的作用。
负边:$s\to a$ 长 $2$,$s\to b$ 长 $3$,$b\to a$ 长 $-2$。Dijkstra 先把 $a$ 定为 $2$,但真实距离为 $1$。
实现上,每次线性扫描求 $\pi$ 的最小值,共 $O(n^2)$;用优先队列维护 $\pi$,共 $n$ 次 ExtractMin 与至多 $m$ 次 ChangeKey,每次 $O(\log n)$,共 $O(m\log n)$。前者适合稠密图,后者适合稀疏图。
算法实现
\begin{algorithm}
\caption{Dijkstra:非负边长的单源最短路}
\begin{algorithmic}
\PROCEDURE{Dijkstra}{$G, \ell, s$}
  \STATE $\pi(s) \gets 0$;对 $v \ne s$,$\pi(v) \gets \infty$
  \STATE $Q \gets$ 以 $\pi$ 为键、包含全部节点的优先队列,$S \gets \emptyset$
  \WHILE{$Q$ 非空}
    \STATE $u \gets$ \CALL{ExtractMin}{$Q$},$d(u) \gets \pi(u)$,$S \gets S \cup \{u\}$
    \FORALL{边 $e = (u, v)$,$v \notin S$}
      \IF{$d(u) + \ell_e < \pi(v)$}
        \STATE $\pi(v) \gets d(u) + \ell_e$,\CALL{ChangeKey}{$Q, v, \pi(v)$}
      \ENDIF
    \ENDFOR
  \ENDWHILE
  \RETURN $d$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
7. 切割性质:最小生成树
给定连通无向图 $G=(V,E)$ 与边权 $c_e$,求总权最小的生成树 $T\subseteq E$。
由 Cayley 公式,完全图 $K_n$ 有 $n^{n-2}$ 棵生成树,枚举不可行;算法至少要读入所有边,下界为 $\Omega(m)$。不妨设边权互不相同(否则按编号打破平局,下面的论证不变)。
生成树上有两种基本的局部修改:
基本回路:向 $T$ 加入非树边 $e$,恰好形成一个圈 $C$;删去 $C$ 上任一边 $f$,得到新的生成树。若 $c_e < c_f$,则 $T$ 不是最小的;
基本割:从 $T$ 删去树边 $f$,节点分成两个连通块,记跨越两块的边集为 $D$;加入 $D$ 中任一边 $e$,得到新的生成树。若 $c_e < c_f$,则 $T$ 不是最小的。
两者都是交换,据此得到判断一条边“必选”与“必不选”的两条性质:
设 $S$ 是 $V$ 的非空真子集,$e$ 是一端在 $S$、另一端在 $V-S$ 的边中权最小的一条,则每棵最小生成树都包含 $e$。
设生成树 $T$ 不含 $e=(v,w)$,$v\in S$,$w\notin S$。$T$ 中 $v$ 到 $w$ 的路径必在某处跨出 $S$,设该边为 $f$。$T-\{f\}+\{e\}$ 仍连通且有 $n-1$ 条边,是生成树;由 $c_e < c_f$,它比 $T$ 更小。$\square$
设 $e$ 是某个圈 $C$ 上权最大的边,则任何最小生成树都不包含 $e$。
设生成树 $T$ 含 $e$。删去 $e$ 后 $T$ 分成两块 $S$ 与 $V-S$;$C-\{e\}$ 是连接 $e$ 两端的路径,必有一边 $f$ 跨越两块。$T-\{e\}+\{f\}$ 是生成树,且 $c_f < c_e$。$\square$
于是有三种贪心,正确性都是两条性质的直接推论:
Kruskal:按权升序考察每条边,不成圈就加入。加入 $e=(v,w)$ 时,取 $S$ 为加入前 $v$ 所在的连通块:$w\notin S$;而比 $e$ 小、跨越 $S$ 的边若存在,早就被加入了。故 $e$ 是跨越 $S$ 的最小边,由切割性质必选;
Prim:从任一根 $s$ 出发,每次加入一端在当前树内、另一端在树外的最小边。取 $S$ 为当前树的节点集,直接由切割性质;
Reverse-Delete:按权降序考察每条边,删去后图仍连通就删去。被删的边位于当前图的某个圈上;比它大的边都已考察过,留下来的是删去就会断开的桥,不在任何圈上,故圈上其余的边都比它小,由回路性质必不选。
三者都输出无圈的连通子图(图连通时,每个割都有边跨越),即生成树;且每一步的决策都与最小生成树一致,故都给出最小生成树。
Prim 与 Dijkstra 几乎相同:把 Dijkstra 的键 $d(u)+\ell_e$ 换成 $c_e$ 即可,用优先队列实现为 $O(m\log n)$。Kruskal 需要快速判断“加入 $e$ 是否成圈”,即 $e$ 的两端是否已在同一连通块,这由并查集完成:
并查集用有根树表示每个集合,Find 沿父指针走到根,Union 将较小树的根挂到较大树的根下。则任一节点的深度不超过 $\log_2 n$。
节点的深度只在它所在的树被挂到另一棵不小于它的树下时加 $1$,此时它所在集合的大小至少翻倍。集合大小不超过 $n$,故深度至多增加 $\log_2 n$ 次。$\square$
于是 Find 为 $O(\log n)$,Union 为 $O(1)$。排序 $O(m\log m)=O(m\log n)$,$2m$ 次 Find 与 $n-1$ 次 Union,Kruskal 共 $O(m\log n)$。
算法实现
\begin{algorithm}
\caption{Kruskal 与并查集}
\begin{algorithmic}
\PROCEDURE{Kruskal}{$G, c$}
  \STATE 将边按权升序排序,使 $c_{e_1} \le c_{e_2} \le \dots \le c_{e_m}$
  \FORALL{$v \in V$}
    \STATE $\mathrm{parent}(v) \gets v$,$\mathrm{size}(v) \gets 1$
  \ENDFOR
  \STATE $T \gets \emptyset$
  \FOR{$i \gets 1$ \TO $m$}
    \STATE $(u, v) \gets e_i$,$a \gets$ \CALL{Find}{$u$},$b \gets$ \CALL{Find}{$v$}
    \IF{$a \ne b$}
      \STATE $T \gets T \cup \{e_i\}$,\CALL{Union}{$a, b$} \COMMENT{不同连通块,不成圈}
    \ENDIF
  \ENDFOR
  \RETURN $T$
\ENDPROCEDURE
\PROCEDURE{Find}{$u$}
  \WHILE{$\mathrm{parent}(u) \ne u$}
    \STATE $u \gets \mathrm{parent}(u)$
  \ENDWHILE
  \RETURN $u$
\ENDPROCEDURE
\PROCEDURE{Union}{$a, b$}
  \IF{$\mathrm{size}(a) < \mathrm{size}(b)$}
    \STATE 交换 $a, b$
  \ENDIF
  \STATE $\mathrm{parent}(b) \gets a$,$\mathrm{size}(a) \gets \mathrm{size}(a) + \mathrm{size}(b)$ \COMMENT{小树挂到大树下}
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
路径压缩
Find 时把沿途节点直接挂到根上,与按大小合并一起,$m$ 次操作的总代价为 $O(m\,\alpha(n))$,其中 $\alpha$ 是反 Ackermann 函数,对一切实际的 $n$ 都不超过 $4$。此时 Kruskal 的瓶颈只剩排序。
8. 结构下界:聚类
给定 $n$ 个对象 $p_1,\dots,p_n$ 及距离 $d(p_i,p_j)$($d(p_i,p_j)=0$ 当且仅当 $p_i=p_j$,非负,对称)与整数 $k$。将对象分成 $k$ 个非空的簇,使间隔(不同簇中两点的最小距离)最大。
把对象看作完全图的节点、距离看作边权。贪心则考虑单链接聚类:从 $n$ 个单点簇开始,反复找出属于不同簇的最近两点并把它们的簇合并,直到剩下 $k$ 个簇。这恰好是 Kruskal 在剩 $k$ 个连通块时停下,等价于求出最小生成树后删去最大的 $k-1$ 条边。
删去最小生成树中最大的 $k-1$ 条边所得的 $k$ 个连通块 $C^*_1,\dots,C^*_k$,是间隔最大的 $k$-聚类。
$C^*$ 的间隔是被删去的边中最小的那条的长度 $d^*$,即最小生成树中第 $k-1$ 大的边。任取另一个 $k$-聚类 $C$,则存在 $p_i,p_j$ 在 $C^*$ 中同属某个 $C^*_r$,在 $C$ 中却分属不同的簇。$C^*_r$ 中 $p_i$ 到 $p_j$ 的树路径上,必有一条边 $(p,q)$ 跨越 $C$ 的两个不同的簇;这条边是 Kruskal 在停下之前加入的,长度 $\le d^*$。故 $C$ 的间隔 $\le d(p,q)\le d^*$。$\square$
与区间划分相同,这是结构下界:$C^*$ 内部的树边构成一条“由短边连成的链”,任何其它聚类只要切断这条链,就付出了不超过 $d^*$ 的间隔。
算法实现
\begin{algorithm}
\caption{Single-Link:最大间隔 $k$-聚类}
\begin{algorithmic}
\PROCEDURE{SingleLink}{$p_1, \dots, p_n;\ d;\ k$}
  \STATE 将全部 $\binom n2$ 个点对按距离升序排序
  \STATE 每个 $p_i$ 自成一簇,$c \gets n$
  \FORALL{点对 $(p_i, p_j)$,按上述顺序}
    \IF{$c = k$}
      \RETURN 当前的 $k$ 个簇 \COMMENT{即 Kruskal 提前停止}
    \ENDIF
    \IF{\CALL{Find}{$p_i$} $\ne$ \CALL{Find}{$p_j$}}
      \STATE \CALL{Union}{\CALL{Find}{$p_i$}, \CALL{Find}{$p_j$}},$c \gets c - 1$
    \ENDIF
  \ENDFOR
  \RETURN 当前的 $k$ 个簇
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
9. 几个小例子
找零:硬币面值为 $1,5,10,25,100$,用最少的硬币凑出金额 $x$。收银员算法每次取不超过剩余金额的最大面值。它最优吗?
先看最优解的结构:$1$ 至多 $4$ 枚(否则用 $5$ 替换),$5$ 至多 $1$ 枚,$25$ 至多 $3$ 枚;$5$ 与 $10$ 合计至多 $2$ 枚($3$ 枚 $10$ 可换成 $25+5$,$2$ 枚 $10$ 加 $1$ 枚 $5$ 可换成 $25$)。于是最优解中,小于 $c_k$ 的硬币总额至多为
$c_k$ $5$ $10$ $25$ $100$ 更小硬币的总额上限 $4$ $4+5=9$ $20+4=24$ $75+24=99$ 都小于 $c_k$。对 $x$ 归纳:设 $c_k$ 是不超过 $x$ 的最大面值,若最优解不用 $c_k$,就要用更小的硬币凑出 $x\ge c_k$,与上表矛盾;故最优解也取 $c_k$,剩下的 $x-c_k$ 由归纳假设被贪心最优地解决。$\square$
但这依赖于面值本身。美国邮票面值 $1,10,21,34,70,100,350,1225,1500$ 下,贪心凑 $140$ 得 $100+34+6\times1$ 共 $8$ 枚,而最优是 $70+70$;面值为 $7,8,9$ 时,贪心凑 $15$ 先取 $9$,剩下的 $6$ 无法凑出,而 $7+8$ 可行。
算法实现
\begin{algorithm}
\caption{Cashier:收银员算法}
\begin{algorithmic}
\PROCEDURE{Cashier}{$x;\ c_1 < c_2 < \dots < c_n$}
  \STATE $S \gets$ 空的多重集
  \WHILE{$x > 0$}
    \STATE $k \gets$ 满足 $c_k \le x$ 的最大下标
    \IF{不存在这样的 $k$}
      \RETURN 无解
    \ENDIF
    \STATE $x \gets x - c_k$,$S \gets S \cup \{c_k\}$
  \ENDWHILE
  \RETURN $S$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}徒步露营:长为 $L$ 的步道上有营地 $0 < x_1 < \dots < x_n < L$,每天至多走 $d$。每到一个营地,若天黑前到不了下一个营地(或终点)就在此过夜,否则继续走。这能使过夜次数最少吗?
能,用领先论证。设贪心停在 $x_{p_1} < \dots < x_{p_k}$,另一合法方案停在 $x_{q_1} < \dots < x_{q_m}$。先归纳证明 $x_{p_j}\ge x_{q_j}$($j\le\min(k,m)$):$j=1$ 时贪心第一天走得最远;若 $x_{p_{j-1}}\ge x_{q_{j-1}}$,则
$$x_{q_j}-x_{p_{j-1}}\le x_{q_j}-x_{q_{j-1}}\le d,$$即贪心第 $j$ 天能走到 $x_{q_j}$,它停下的位置只会更远。若 $m < k$,则 $x_{q_m}\le x_{p_m} < L-d$(否则贪心不必在 $x_{p_{m+1}}$ 再停),另一方案无法从 $x_{q_m}$ 一天走到终点,矛盾。$\square$
算法实现
\begin{algorithm}
\caption{Camping:走得越远越好}
\begin{algorithmic}
\PROCEDURE{Camping}{$x_1 < \dots < x_n;\ L;\ d$}
  \STATE $x_{n+1} \gets L$,$c \gets 0$,$R \gets \emptyset$ \COMMENT{$c$:上一次过夜的位置}
  \FOR{$i \gets 1$ \TO $n$}
    \IF{$x_{i+1} - c > d$}
      \STATE $R \gets R \cup \{x_i\}$,$c \gets x_i$ \COMMENT{到不了下一个营地,在此过夜}
    \ENDIF
  \ENDFOR
  \RETURN $R$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}购买许可证:每月至多买一个,共 $n$ 个许可证,现价都是 $100$,许可证 $j$ 的价格每月乘以 $r_j > 1$(各 $r_j$ 互不相同),在第 $t$ 个月购买需付 $100\,r_j^t$。按什么顺序购买总价最低?
按 $r_j$ 降序购买,用交换论证。若相邻两月 $t,t+1$ 购买的增长率满足 $r < r'$(逆序),交换二者,总价的变化量为
$$ \left(r'^{\,t}+r^{t+1}\right)-\left(r^t+r'^{\,t+1}\right)=r^t(r-1)-r'^{\,t}(r'-1) < 0, $$严格变小,故最优解无逆序,即为降序。排序共 $O(n\log n)$。若价格是折旧的($r_j<1$,卖出而非买入),结论就不再成立:对 $\tfrac34,\tfrac12,\tfrac1{100}$,最优顺序既非升序也非降序。$\square$
判定一条边是否在最小生成树中:边权互不相同,给定边 $e=(v,w)$,在 $O(m+n)$ 内判断 $e$ 是否属于最小生成树。
$e$ 不在最小生成树中,当且仅当 $v,w$ 之间有一条只由比 $e$ 小的边组成的路径。若有,这条路径加上 $e$ 构成一个圈,$e$ 是其中最大的边,由回路性质排除。若没有,取 $S$ 为从 $v$ 出发只走比 $e$ 小的边能到达的节点,则 $w\notin S$,且没有比 $e$ 小的边跨越 $S$(否则其另一端也可达),$e$ 是跨越 $S$ 的最小边,由切割性质必选。于是只需删去所有不小于 $c_e$ 的边,再用 BFS 判断 $v,w$ 是否连通。$\square$
算法实现
\begin{algorithm}
\caption{In-MST:判定边是否属于最小生成树}
\begin{algorithmic}
\PROCEDURE{InMST}{$G, c, e = (v, w)$}
  \STATE $G' \gets (V, \{f \in E : c_f < c_e\})$ \COMMENT{$O(m + n)$}
  \STATE $R \gets$ 在 $G'$ 中从 $v$ 出发 BFS 到达的节点集 \COMMENT{$O(m + n)$}
  \RETURN $w \notin R$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
10. 小结
| 问题 | 贪心准则 | 论证 | 复杂度 |
|---|---|---|---|
| 区间调度 | 最早结束 | 领先 | $O(n\log n)$ |
| 区间划分 | 最早开始,放入任一空闲教室 | 结构下界(深度) | $O(n\log n)$ |
| 最小化最大延迟 | 最早截止 | 交换(相邻逆序) | $O(n\log n)$ |
| 离线缓存 | 驱逐最远将来才用的项 | 交换(逐步同步) | $O(m\log k)$ |
| 单源最短路 | 加入 $\pi$ 最小的节点 | 领先(不变量) | $O(m\log n)$ |
| 最小生成树 | Kruskal / Prim / Reverse-Delete | 交换(切割与回路性质) | $O(m\log n)$ |
| 最大间隔聚类 | 单链接(提前停止的 Kruskal) | 结构下界 | $O(n^2\log n)$ |
贪心的分析与设计,都可以归结为与最优解的比较:先用小反例淘汰候选准则,再为剩下的准则找到比较的方式——一个随步数单调的量(领先)、一种不使目标变差的局部修改(交换),或一个所有解都绕不过的瓶颈(结构下界)。复杂度通常由排序和维护候选集的数据结构(堆、并查集)决定,很少成为难点。
11. 补充:贪心何时成立
找零的例子说明,同一个贪心准则是否正确,取决于问题的结构而非准则本身。对“选一个子集使总权最大”这类问题,这种结构可以精确刻画。
有限集 $E$ 与一族子集 $\mathcal I$(称为独立集)构成拟阵,若:(1)$\emptyset\in\mathcal I$;(2)遗传性:$B\in\mathcal I$,$A\subseteq B\implies A\in\mathcal I$;(3)交换性:$A,B\in\mathcal I$,$|A| < |B|\implies$ 存在 $x\in B-A$ 使 $A\cup\{x\}\in\mathcal I$。
只满足(1)(2)的称为独立系统。由交换性,拟阵中所有极大独立集(基)大小相同。典型的例子是图拟阵:$E$ 为图的边集,独立集为无圈的边集(森林)。交换性成立,因为森林 $A$ 有 $n-|A|$ 个连通块,$B$ 的连通块更少,若 $B$ 的每条边都落在 $A$ 的某个连通块内部,$B$ 的连通块就不会比 $A$ 少,故 $B$ 中有一边连接 $A$ 的两个不同连通块,加入 $A$ 不成圈。
设 $(E,\mathcal I)$ 是独立系统,对 $E$ 中元素赋予非负权。按权降序考察每个元素、保持独立就加入的贪心,对一切非负权都能求出权最大的独立集,当且仅当 $(E,\mathcal I)$ 是拟阵。
充分性(领先论证)。不妨设权都为正(权为零的元素不影响最优值)。设贪心依次选出 $a_1,\dots,a_k$,它是一个基;任取独立集 $b_1,\dots,b_l$,按权降序排列,由基的大小相同,$l\le k$。断言 $w(a_i)\ge w(b_i)$ 对一切 $i\le l$ 成立。否则取首个 $w(a_i) < w(b_i)$ 的 $i$,对 $\{a_1,\dots,a_{i-1}\}$ 与 $\{b_1,\dots,b_i\}$ 用交换性,得 $b_j$($j\le i$)使 $\{a_1,\dots,a_{i-1},b_j\}$ 独立,且 $w(b_j)\ge w(b_i) > w(a_i)$。贪心在 $a_i$ 之前已考察过 $b_j$,那时已选集合是 $\{a_1,\dots,a_{i-1}\}$ 的子集,由遗传性加入 $b_j$ 仍独立,贪心必会选它,矛盾。于是 $w(A)\ge w(B)$。
必要性。若交换性对某对 $A,B$ 不成立,$|A|=a < |B|$,令 $A$ 中元素权为 $1+\varepsilon$,$B-A$ 中元素权为 $1$,其余为 $0$,取 $\varepsilon < 1/a$。贪心先选入整个 $A$,此后 $B-A$ 中任何元素都无法加入(加入 $A$ 已不独立,由遗传性加入更大的集合也不独立),得到 $a(1+\varepsilon) < a+1\le |B|\le w(B)$。$\square$
最大生成树就是图拟阵上的贪心;最小生成树取 $w_e=C-c_e$($C$ 为足够大的常数)即可,这正是 Kruskal。反之,相容区间的集合是独立系统而不是拟阵:$A=\{[0,10)\}$,$B=\{[0,1),[2,3)\}$,$B$ 中没有任何区间能加入 $A$。所以区间调度的贪心只对“每个任务权为 $1$”成立,依赖的是按结束时间排序这一特殊结构;任务带权时,最早结束优先不再正确,需要动态规划。
找零的面值系统
使收银员算法对一切金额都最优的面值系统称为规范的。Kozen 与 Zaks(1994)证明:若面值系统不规范,最小的反例 $x$ 满足 $c_3+1 < x < c_n+c_{n-1}$,于是只需检查有限个金额;Pearson(2005)给出了 $O(n^3)$ 的判定算法。对不规范的面值系统,找零需要动态规划。