有了 SAT、3SAT 与独立集,证明一个新问题 X X X X ∈ N P X\in\mathrm{NP} X ∈ NP X X X 部件 模拟变量与子句,再用约束迫使部件的局部选择拼成一个全局一致的解。
1. 引入:归约的模板# 已知 Y Y Y X X X 第一步,X ∈ N P X\in\mathrm{NP} X ∈ NP :指出证书,说明它长度多项式、可在多项式时间内验证。这一步通常是平凡的,但不能省略;
第二步,Y ≤ p X Y\le_p X Y ≤ p X :给出多项式时间变换 f f f y ∈ Y ⇒ f ( y ) ∈ X y\in Y\Rightarrow f(y)\in X y ∈ Y ⇒ f ( y ) ∈ X Y Y Y X X X f ( y ) ∈ X ⇒ y ∈ Y f(y)\in X\Rightarrow y\in Y f ( y ) ∈ X ⇒ y ∈ Y X X X Y Y Y
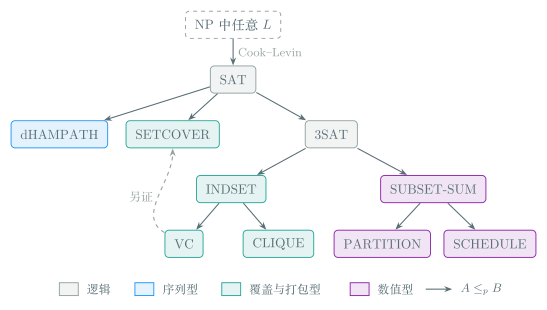
本章的归约关系如下,箭头 A → B A\to B A → B A ≤ p B A\le_p B A ≤ p B
Fig 1 本章的归约关系 按问题的结构,可以粗分为序列型 (哈密顿路)、覆盖与打包型 (集合覆盖、顶点覆盖、独立集、团)与数值型 (子集和、划分、调度)三类。
2. 序列型:有向哈密顿路# 有向图中的有向哈密顿路 是恰好经过每个顶点一次的有向路径。d H A M P A T H \mathrm{dHAMPATH} dHAMPATH dHAMPATH 是 NP 完全的。
dHAMPATH 显然属于 NP(证书是顶点序列)。下面给出 S A T ≤ p d H A M P A T H \mathrm{SAT}\le_p\mathrm{dHAMPATH} SAT ≤ p dHAMPATH
设 φ \varphi φ n n n m m m G G G
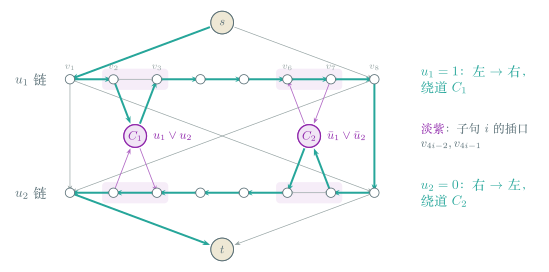
每个子句 C C C v C v_C v C m m m 起点 v s t a r t v_{\mathrm{start}} v start v e n d v_{\mathrm{end}} v end 每个变量 u j u_j u j 4 m 4m 4 m 链 v 1 , … , v 4 m v_1,\dots,v_{4m} v 1 , … , v 4 m v i , v i + 1 v_i,v_{i+1} v i , v i + 1 边包括:
v s t a r t v_{\mathrm{start}} v start j j j j + 1 j+1 j + 1 j ∈ [ n − 1 ] j\in[n-1] j ∈ [ n − 1 ] n n n v e n d v_{\mathrm{end}} v end 对第 i i i C C C u j u_j u j j j j C C C v 4 i − 2 , v 4 i − 1 v_{4i-2},v_{4i-1} v 4 i − 2 , v 4 i − 1 C C C u j u_j u j v 4 i − 2 → v C → v 4 i − 1 v_{4i-2}\to v_C\to v_{4i-1} v 4 i − 2 → v C → v 4 i − 1 C C C u ˉ j \bar u_j u ˉ j v 4 i − 1 → v C → v 4 i − 2 v_{4i-1}\to v_C\to v_{4i-2} v 4 i − 1 → v C → v 4 i − 2 于是从左到右走一条链表示 u j = 1 u_j=1 u j = 1 u j = 0 u_j=0 u j = 0 ;子句顶点只能从「方向正确」的链上绕道访问。构造显然是多项式时间的。
(⇒ \Rightarrow ⇒ u u u v s t a r t v_{\mathrm{start}} v start v e n d v_{\mathrm{end}} v end u j = 1 u_j=1 u j = 1 j j j u j = 0 u_j=0 u j = 0 C C C C C C v C v_C v C
(⇐ \Leftarrow ⇐ P P P v s t a r t v_{\mathrm{start}} v start v e n d v_{\mathrm{end}} v end P P P v s t a r t v_{\mathrm{start}} v start v e n d v_{\mathrm{end}} v end P P P v → v C v\to v_C v → v C v C → w v_C\to w v C → w w w w v v v P P P w w w w w w v C v_C v C w w w v e n d v_{\mathrm{end}} v end P P P P P P j j j u j = 1 u_j=1 u j = 1 u j = 0 u_j=0 u j = 0 P P P v C v_C v C u u u u u u φ \varphi φ □ \square □
Fig 2 φ = ( u 1 ∨ u 2 ) ∧ ( u ˉ 1 ∨ u ˉ 2 ) \varphi=(u_1\vee u_2)\wedge(\bar u_1\vee\bar u_2) φ = ( u 1 ∨ u 2 ) ∧ ( u ˉ 1 ∨ u ˉ 2 ) u 1 = 1 , u 2 = 0 u_1=1,\ u_2=0 u 1 = 1 , u 2 = 0 部件的分工很清楚:链 是变量部件,只有两种走法;绕道 是子句部件,只在方向正确时可用;链与链的首尾相接保证每个变量恰好被「赋值」一次。
从 dHAMPATH 出发,哈密顿问题的各种变体都能用很小的改动得到:
有向哈密顿圈 :在上面的构造里加一条边 v e n d → v s t a r t v_{\mathrm{end}}\to v_{\mathrm{start}} v end → v start v s t a r t v_{\mathrm{start}} v start v s t a r t v_{\mathrm{start}} v start v e n d v_{\mathrm{end}} v end
无向哈密顿圈 :把有向图的每个顶点 v v v v i n − v m i d − v o u t v_{\mathrm{in}}-v_{\mathrm{mid}}-v_{\mathrm{out}} v in − v mid − v out u → v u\to v u → v u o u t − v i n u_{\mathrm{out}}-v_{\mathrm{in}} u out − v in v m i d v_{\mathrm{mid}} v mid v i n , v m i d , v o u t v_{\mathrm{in}},v_{\mathrm{mid}},v_{\mathrm{out}} v in , v mid , v out v o u t v_{\mathrm{out}} v out v m i d v_{\mathrm{mid}} v mid w i n w_{\mathrm{in}} w in → \to → → \to → u o u t − v i n u_{\mathrm{out}}-v_{\mathrm{in}} u out − v in
旅行商 :再用上一章的 H A M C Y C L E ≤ p T S P \mathrm{HAMCYCLE}\le_p\mathrm{TSP} HAMCYCLE ≤ p TSP
拆点的技巧值得记住:用一个度数为 2 的中间点「钩住」两个端点,就把方向信息编码进了无向图。
3. 覆盖与打包型# 3.1 集合覆盖# 集合覆盖 :给定有限集族 S 1 , … , S m S_1,\dots,S_m S 1 , … , S m K K K K K K ⋃ i = 1 m S i \bigcup_{i=1}^m S_i ⋃ i = 1 m S i i 1 , … , i K i_1,\dots,i_K i 1 , … , i K ⋃ j = 1 K S i j = ⋃ i = 1 m S i \bigcup_{j=1}^K S_{i_j}=\bigcup_{i=1}^m S_i ⋃ j = 1 K S i j = ⋃ i = 1 m S i 集合覆盖是 NP 完全的。
集合覆盖显然属于 NP。下面给出 S A T ≤ p S E T C O V E R \mathrm{SAT}\le_p\mathrm{SETCOVER} SAT ≤ p SETCOVER
设 φ \varphi φ n n n m m m S i , t S_{i,t} S i , t S i , f S_{i,f} S i , f i i i { 1 , … , m } \{1,\dots,m\} { 1 , … , m } 2 n 2n 2 n { 1 , … , m } \{1,\dots,m\} { 1 , … , m } m + i m+i m + i
S 2 i − 1 = S i , t ∪ { m + i } , S 2 i = S i , f ∪ { m + i } , i = 1 , … , n , S_{2i-1}=S_{i,t}\cup\{m+i\},\qquad S_{2i}=S_{i,f}\cup\{m+i\},\qquad i=1,\dots,n, S 2 i − 1 = S i , t ∪ { m + i } , S 2 i = S i , f ∪ { m + i } , i = 1 , … , n , 取 K = n K=n K = n { 1 , … , m + n } \{1,\dots,m+n\} { 1 , … , m + n }
(⇒ \Rightarrow ⇒ u u u φ \varphi φ { S 2 i − u i : i = 1 , … , n } \{S_{2i-u_i}:i=1,\dots,n\} { S 2 i − u i : i = 1 , … , n } u i = 1 u_i=1 u i = 1 S 2 i − 1 S_{2i-1} S 2 i − 1 S 2 i S_{2i} S 2 i n n n m + i m+i m + i
(⇐ \Leftarrow ⇐ n n n { 1 , … , m + n } \{1,\dots,m+n\} { 1 , … , m + n } m + i m+i m + i S 2 i − 1 , S 2 i S_{2i-1},S_{2i} S 2 i − 1 , S 2 i i i i n n n u i = 1 u_i=1 u i = 1 S 2 i − 1 S_{2i-1} S 2 i − 1 { S 2 i − u i } \{S_{2i-u_i}\} { S 2 i − u i } { 1 , … , m } \{1,\dots,m\} { 1 , … , m } □ \square □
新元素 m + i m+i m + i 恰选其一 」的约束:它把集合覆盖的自由选择限制为一个赋值。
3.2 顶点覆盖、独立集与团# 顶点覆盖 :给定图 G G G K K K K K K
团 :给定图 G G G K K K K K K
设 G = ( V , E ) G=(V,E) G = ( V , E ) G ˉ = ( V , E ˉ ) \bar G=(V,\bar E) G ˉ = ( V , E ˉ ) e ∈ E ˉ ⟺ e ∉ E e\in\bar E\iff e\notin E e ∈ E ˉ ⟺ e ∈ / E
S S S G G G ⟺ \iff ⟺ V ∖ S V\setminus S V ∖ S G G G S S S G G G ⟺ \iff ⟺ S S S G ˉ \bar G G ˉ 从而顶点覆盖与团都是 NP 完全的。
(1)S S S ⟺ \iff ⟺ S S S ⟺ \iff ⟺ V ∖ S V\setminus S V ∖ S
(2)S S S G G G ⟺ \iff ⟺ G ˉ \bar G G ˉ
于是 ⟨ G , k ⟩ ↦ ⟨ G , n − k ⟩ \langle G,k\rangle\mapsto\langle G,n-k\rangle ⟨ G , k ⟩ ↦ ⟨ G , n − k ⟩ I N D S E T ≤ p V C \mathrm{INDSET}\le_p\mathrm{VC} INDSET ≤ p VC ⟨ G , k ⟩ ↦ ⟨ G ˉ , k ⟩ \langle G,k\rangle\mapsto\langle\bar G,k\rangle ⟨ G , k ⟩ ↦ ⟨ G ˉ , k ⟩ I N D S E T ≤ p C L I Q U E \mathrm{INDSET}\le_p\mathrm{CLIQUE} INDSET ≤ p CLIQUE □ \square □
三者在计算上是等价的。另外,顶点覆盖是集合覆盖的特例:令 S v = { e ∈ E : v ∈ e } S_v=\{e\in E:v\in e\} S v = { e ∈ E : v ∈ e } K K K S v S_v S v E E E V C ≤ p S E T C O V E R \mathrm{VC}\le_p\mathrm{SETCOVER} VC ≤ p SETCOVER
4. 数值型# 对算术问题,输入的整数以二进制 编码,多项式时间归约必须是二进制编码长度的多项式。因此构造中出现的数可以是指数大的,只要位数是多项式的。
4.1 子集和# 子集和 (SUBSET-SUM):给定自然数 w 1 , … , w n w_1,\dots,w_n w 1 , … , w n W W W W W W 例如 { 1 , 4 , 16 , 64 , 256 , 1040 , 1041 , 1093 , 1284 , 1344 } \{1,4,16,64,256,1040,1041,1093,1284,1344\} { 1 , 4 , 16 , 64 , 256 , 1040 , 1041 , 1093 , 1284 , 1344 } W = 3754 W=3754 W = 3754 1 + 16 + 64 + 256 + 1040 + 1093 + 1284 = 3754 1+16+64+256+1040+1093+1284=3754 1 + 16 + 64 + 256 + 1040 + 1093 + 1284 = 3754
3 S A T ≤ p S U B S E T - S U M \mathrm{3SAT}\le_p\mathrm{SUBSET\text{-}SUM} 3SAT ≤ p SUBSET - SUM 设 3SAT 实例 Φ \Phi Φ n n n k k k 2 n + 2 k 2n+2k 2 n + 2 k n + k n+k n + k n n n k k k
对每个变量 x i x_i x i t i t_i t i x i x_i x i f i f_i f i x ˉ i \bar x_i x ˉ i i i i t i t_i t i x i x_i x i f i f_i f i x ˉ i \bar x_i x ˉ i 对每个子句 C j C_j C j 填充数 ,只在子句位 j j j 目标 W W W 例如 C 1 = x ˉ ∨ y ∨ z C_1=\bar x\vee y\vee z C 1 = x ˉ ∨ y ∨ z C 2 = x ∨ y ˉ ∨ z C_2=x\vee\bar y\vee z C 2 = x ∨ y ˉ ∨ z C 3 = x ˉ ∨ y ˉ ∨ z ˉ C_3=\bar x\vee\bar y\vee\bar z C 3 = x ˉ ∨ y ˉ ∨ z ˉ
x x x y y y z z z C 1 C_1 C 1 C 2 C_2 C 2 C 3 C_3 C 3 数值 x x x 1 0 0 0 1 0 100,010 x ˉ \bar x x ˉ 1 0 0 1 0 1 100,101 y y y 0 1 0 1 0 0 10,100 y ˉ \bar y y ˉ 0 1 0 0 1 1 10,011 z z z 0 0 1 1 1 0 1,110 z ˉ \bar z z ˉ 0 0 1 0 0 1 1,001 填充 0 0 0 1 0 0 100 填充 0 0 0 2 0 0 200 填充 0 0 0 0 1 0 10 填充 0 0 0 0 2 0 20 填充 0 0 0 0 0 1 1 填充 0 0 0 0 0 2 2 W W W 1 1 1 4 4 4 111,444
不进位 :每个变量位上至多两个 1;每个子句位上至多 3 个文字的 1 加上填充数 1 + 2 1+2 1 + 2 6 < 10 6<10 6 < 10 W W W
(⇒ \Rightarrow ⇒ Φ \Phi Φ i i i t i , f i t_i,f_i t i , f i C j C_j C j s ∈ { 1 , 2 , 3 } s\in\{1,2,3\} s ∈ { 1 , 2 , 3 } j j j s s s 4 − s ∈ { 3 , 2 , 1 } 4-s\in\{3,2,1\} 4 − s ∈ { 3 , 2 , 1 }
(⇐ \Leftarrow ⇐ W W W i i i t i , f i t_i,f_i t i , f i j j j 3 3 3 C j C_j C j □ \square □
例:表中实例的一个解
赋值 x = 0 , y = 0 , z = 1 x=0,\ y=0,\ z=1 x = 0 , y = 0 , z = 1 C 1 , C 3 C_1,C_3 C 1 , C 3 x ˉ \bar x x ˉ C 2 C_2 C 2 y ˉ \bar y y ˉ x ˉ , y ˉ , z \bar x,\bar y,z x ˉ , y ˉ , z
100,101 + 10,011 + 1,110 = 111,222 , 100{,}101+10{,}011+1{,}110=111{,}222, 100 , 101 + 10 , 011 + 1 , 110 = 111 , 222 , 三个子句位各得 2 2 2 2 2 2 111,222 + 200 + 20 + 2 = 111,444 = W 111{,}222+200+20+2=111{,}444=W 111 , 222 + 200 + 20 + 2 = 111 , 444 = W 1 + 2 = 3 < 4 1+2=3<4 1 + 2 = 3 < 4
伪多项式算法与弱 NP 完全
子集和有 O ( n W ) O(nW) O ( nW ) O P T ( i , w ) \mathrm{OPT}(i,w) OPT ( i , w ) i i i w w w W W W log W \log W log W O ( n W ) O(nW) O ( nW ) 指数 ,称为伪多项式 时间。上述归约中的数有 n + k n+k n + k 弱 NP 完全 ,而在数值为输入长度多项式时仍 NP 完全的问题(如 3-PARTITION)称为强 NP 完全 。
4.2 划分# 划分 (PARTITION):给定自然数 v 1 , … , v m v_1,\dots,v_m v 1 , … , v m 1 2 ∑ i v i \frac12\sum_i v_i 2 1 ∑ i v i S U B S E T - S U M ≤ p P A R T I T I O N \mathrm{SUBSET\text{-}SUM}\le_p\mathrm{PARTITION} SUBSET - SUM ≤ p PARTITION 设 W , w 1 , … , w n W,w_1,\dots,w_n W , w 1 , … , w n Σ = ∑ i w i \Sigma=\sum_i w_i Σ = ∑ i w i W ≤ Σ W\le\Sigma W ≤ Σ m = n + 2 m=n+2 m = n + 2
v i = w i ( i ≤ n ) , v n + 1 = 2 Σ − W , v n + 2 = Σ + W . v_i=w_i\ (i\le n),\qquad v_{n+1}=2\Sigma-W,\qquad v_{n+2}=\Sigma+W. v i = w i ( i ≤ n ) , v n + 1 = 2Σ − W , v n + 2 = Σ + W . 总和为 4 Σ 4\Sigma 4Σ 2 Σ 2\Sigma 2Σ v n + 1 + v n + 2 = 3 Σ > 2 Σ v_{n+1}+v_{n+2}=3\Sigma>2\Sigma v n + 1 + v n + 2 = 3Σ > 2Σ v n + 1 v_{n+1} v n + 1 2 Σ − ( 2 Σ − W ) = W 2\Sigma-(2\Sigma-W)=W 2Σ − ( 2Σ − W ) = W w i w_i w i { w i } i ∈ A \{w_i\}_{i\in A} { w i } i ∈ A W W W A ∪ { n + 1 } A\cup\{n+1\} A ∪ { n + 1 } □ \square □
4.3 带释放时间的调度# 调度 (SCHEDULE):给定 n n n j j j t j t_j t j r j r_j r j d j d_j d j j j j [ r j , d j ] [r_j,d_j] [ r j , d j ] t j t_j t j S U B S E T - S U M ≤ p S C H E D U L E \mathrm{SUBSET\text{-}SUM}\le_p\mathrm{SCHEDULE} SUBSET - SUM ≤ p SCHEDULE 设 W , w 1 , … , w n W,w_1,\dots,w_n W , w 1 , … , w n Σ = ∑ i w i \Sigma=\sum_i w_i Σ = ∑ i w i n + 1 n+1 n + 1
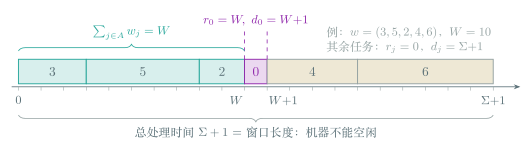
任务 j ∈ [ n ] j\in[n] j ∈ [ n ] t j = w j t_j=w_j t j = w j r j = 0 r_j=0 r j = 0 d j = Σ + 1 d_j=\Sigma+1 d j = Σ + 1 任务 0 0 0 t 0 = 1 t_0=1 t 0 = 1 r 0 = W r_0=W r 0 = W d 0 = W + 1 d_0=W+1 d 0 = W + 1 任务 0 只能占据 [ W , W + 1 ] [W,W+1] [ W , W + 1 ] Σ + 1 \Sigma+1 Σ + 1 [ 0 , Σ + 1 ] [0,\Sigma+1] [ 0 , Σ + 1 ] [ 0 , W ] [0,W] [ 0 , W ] w j w_j w j W W W { w j } j ∈ A \{w_j\}_{j\in A} { w j } j ∈ A W W W A A A [ 0 , W ] [0,W] [ 0 , W ] [ W , W + 1 ] [W,W+1] [ W , W + 1 ] [ W + 1 , Σ + 1 ] [W+1,\Sigma+1] [ W + 1 , Σ + 1 ] □ \square □
Fig 3 子集和到调度的归约:任务 0 卡住 [ W , W + 1 ] [W,W+1] [ W , W + 1 ] 与贪心 中最小化最大延迟的问题对比:没有释放时间时,按截止时间排序即为最优;加入释放时间后,问题就变成 NP 完全的。
5. 全景:NP 完全问题的等价类# 以上问题都是 NP 完全的,彼此之间都可以多项式归约。Karp(1972)列出了 21 个 NP 完全问题,包括 SAT、团、集合覆盖、顶点覆盖、哈密顿圈、背包、划分、图着色等,确立了 NP 完全性在组合优化中的普遍地位(Karp 因此获得 1985 年图灵奖)。Garey 与 Johnson 的 Computers and Intractability (1979)是 NP 完全问题的经典目录。
6. 判定与搜索# NP 是用判定问题定义的,而实际中更关心搜索问题:若解存在,把它找出来。搜索至少和判定一样难,所以若 P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
设 P = N P \mathrm P=\mathrm{NP} P = NP L L L M M M B B B x ∈ L x\in L x ∈ L x x x 即证:若 P = N P \mathrm P=\mathrm{NP} P = NP M M M p p p B B B x ∈ { 0 , 1 } n x\in\{0,1\}^n x ∈ { 0 , 1 } n u ∈ { 0 , 1 } p ( n ) u\in\{0,1\}^{p(n)} u ∈ { 0 , 1 } p ( n ) M ( x , u ) = 1 M(x,u)=1 M ( x , u ) = 1 ∣ B ( x ) ∣ = p ( n ) |B(x)|=p(n) ∣ B ( x ) ∣ = p ( n ) M ( x , B ( x ) ) = 1 M(x,B(x))=1 M ( x , B ( x )) = 1
SAT 的情形 :设 A A A n n n φ \varphi φ x 1 = 0 x_1=0 x 1 = 0 A A A x 1 = 0 x_1=0 x 1 = 0 x 1 = 1 x_1=1 x 1 = 1 x 2 , … , x n x_2,\dots,x_n x 2 , … , x n A A A 2 n + 1 2n+1 2 n + 1 n + 1 n+1 n + 1
一般情形 :Cook–Levin 定理中从 L L L f f f x ∈ L ⟺ f ( x ) ∈ S A T x\in L\iff f(x)\in\mathrm{SAT} x ∈ L ⟺ f ( x ) ∈ SAT f ( x ) f(x) f ( x ) x x x f ( x ) f(x) f ( x ) □ \square □
算法实现 \begin{algorithm}
\caption{SAT-Search:用判定算法求满足赋值}
\begin{algorithmic}
\PROCEDURE{FindAssignment}{$\varphi(x_1, \dots, x_n)$}
\IF{\CALL{A}{$\varphi$} $= 0$}
\RETURN 不可满足
\ENDIF
\FOR{$i \gets 1$ \TO $n$}
\IF{\CALL{A}{$\varphi|_{x_i = 0}$} $= 1$}
\STATE $a_i \gets 0$,$\varphi \gets \varphi|_{x_i = 0}$
\ELSE
\STATE $a_i \gets 1$,$\varphi \gets \varphi|_{x_i = 1}$ \COMMENT{$\varphi$ 可满足,故此分支必可满足}
\ENDIF
\ENDFOR
\RETURN $(a_1, \dots, a_n)$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm} 这种「固定一个变量,问剩下的是否仍有解」的性质称为自归约性 。图问题也有类似的写法:要找哈密顿圈,依次尝试删去每条边,若删去后判定算法仍回答「有哈密顿圈」就真的删掉,否则保留。最后剩下的图仍有哈密顿圈,且其中每条边都不可删,所以它就是一个哈密顿圈,共调用判定算法 m + 1 m+1 m + 1 k ∗ k^* k ∗
7. coNP# 对语言 L L L L ‾ = { 0 , 1 } ∗ ∖ L \overline L=\{0,1\}^*\setminus L L = { 0 , 1 } ∗ ∖ L
c o N P = { L : L ‾ ∈ N P } . \mathrm{coNP}=\{L:\overline L\in\mathrm{NP}\}. coNP = { L : L ∈ NP } . 等价地,L ∈ c o N P L\in\mathrm{coNP} L ∈ coNP p p p M M M x x x
x ∈ L ⟺ ∀ u ∈ { 0 , 1 } p ( ∣ x ∣ ) , M ( x , u ) = 1. x\in L\iff\forall u\in\{0,1\}^{p(|x|)},\ M(x,u)=1. x ∈ L ⟺ ∀ u ∈ { 0 , 1 } p ( ∣ x ∣ ) , M ( x , u ) = 1. NP 是「存在简短的肯定 证明」,coNP 是「存在简短的否定 证明」(反例)。注意 coNP 不是 NP 的补集:二者有非空的交,P ⊆ N P ∩ c o N P \mathrm P\subseteq\mathrm{NP}\cap\mathrm{coNP} P ⊆ NP ∩ coNP S A T ‾ = { φ : φ is unsatisfiable } \overline{\mathrm{SAT}}=\{\varphi:\varphi\ \text{is unsatisfiable}\} SAT = { φ : φ is unsatisfiable }
类似地定义 coNP 完全:属于 coNP,且 coNP 中的每个语言都可 Karp 归约到它。
T A U T O L O G Y = { φ : φ is a Boolean formula satisfied by every assignment } \mathrm{TAUTOLOGY}=\{\varphi:\varphi\ \text{is a Boolean formula satisfied by every assignment}\} TAUTOLOGY = { φ : φ is a Boolean formula satisfied by every assignment } TAUTOLOGY 显然属于 coNP:对每个赋值 u u u φ ( u ) = 1 \varphi(u)=1 φ ( u ) = 1
对任意 L ∈ c o N P L\in\mathrm{coNP} L ∈ coNP L ‾ ∈ N P \overline L\in\mathrm{NP} L ∈ NP L ‾ \overline L L x x x φ x \varphi_x φ x φ x \varphi_x φ x ⟺ x ∈ L ‾ \iff x\in\overline L ⟺ x ∈ L
¬ φ x ∈ T A U T O L O G Y ⟺ φ x is unsatisfiable ⟺ x ∈ L , \neg\varphi_x\in\mathrm{TAUTOLOGY}\iff\varphi_x\ \text{is unsatisfiable}\iff x\in L, ¬ φ x ∈ TAUTOLOGY ⟺ φ x is unsatisfiable ⟺ x ∈ L , x ↦ ¬ φ x x\mapsto\neg\varphi_x x ↦ ¬ φ x L ≤ p T A U T O L O G Y L\le_p\mathrm{TAUTOLOGY} L ≤ p TAUTOLOGY □ \square □
这里 ¬ φ x \neg\varphi_x ¬ φ x
若 P = N P \mathrm P=\mathrm{NP} P = NP P = N P = c o N P \mathrm P=\mathrm{NP}=\mathrm{coNP} P = NP = coNP L ∈ c o N P ⟺ L ‾ ∈ N P = P ⟺ L ∈ P L\in\mathrm{coNP}\iff\overline L\in\mathrm{NP}=\mathrm P\iff L\in\mathrm P L ∈ coNP ⟺ L ∈ NP = P ⟺ L ∈ P □ \square □ 逆否地,证明 N P ≠ c o N P \mathrm{NP}\ne\mathrm{coNP} NP = coNP P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
猜想 1 :N P ≠ c o N P \mathrm{NP}\ne\mathrm{coNP} NP = coNP
猜想 2 :P ≠ N P ∩ c o N P \mathrm P\ne\mathrm{NP}\cap\mathrm{coNP} P = NP ∩ coNP
若 N P ≠ c o N P \mathrm{NP}\ne\mathrm{coNP} NP = coNP N P ∩ c o N P \mathrm{NP}\cap\mathrm{coNP} NP ∩ coNP 设 L ∈ N P ∩ c o N P L\in\mathrm{NP}\cap\mathrm{coNP} L ∈ NP ∩ coNP L ′ ∈ N P L'\in\mathrm{NP} L ′ ∈ NP L ′ ≤ p L L'\le_p L L ′ ≤ p L f f f x ∈ L ′ ‾ ⟺ f ( x ) ∈ L ‾ x\in\overline{L'}\iff f(x)\in\overline L x ∈ L ′ ⟺ f ( x ) ∈ L L ′ ‾ ≤ p L ‾ \overline{L'}\le_p\overline L L ′ ≤ p L L ‾ ∈ N P \overline L\in\mathrm{NP} L ∈ NP L ′ ‾ ∈ N P \overline{L'}\in\mathrm{NP} L ′ ∈ NP L ′ ∈ c o N P L'\in\mathrm{coNP} L ′ ∈ coNP N P ⊆ c o N P \mathrm{NP}\subseteq\mathrm{coNP} NP ⊆ coNP c o N P ⊆ N P \mathrm{coNP}\subseteq\mathrm{NP} coNP ⊆ NP N P = c o N P \mathrm{NP}=\mathrm{coNP} NP = coNP □ \square □ 所以整数分解(判定版本属于 N P ∩ c o N P \mathrm{NP}\cap\mathrm{coNP} NP ∩ coNP
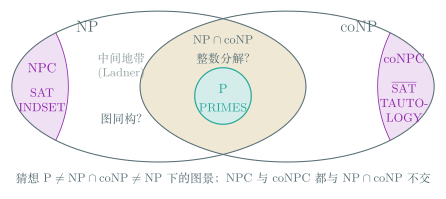
若 P ≠ N P \mathrm P\ne\mathrm{NP} P = NP L ∈ N P ∖ P L\in\mathrm{NP}\setminus\mathrm P L ∈ NP ∖ P L L L Ladner 构造的语言是人为的;自然的候选是整数分解与图同构。在 P ≠ N P ∩ c o N P ≠ N P \mathrm P\ne\mathrm{NP}\cap\mathrm{coNP}\ne\mathrm{NP} P = NP ∩ coNP = NP N P ∩ c o N P \mathrm{NP}\cap\mathrm{coNP} NP ∩ coNP N P ∩ c o N P \mathrm{NP}\cap\mathrm{coNP} NP ∩ coNP
Fig 4 P、NP 与 coNP 的猜想图景 8. EXP 与 NEXP# E X P = ⋃ c ≥ 0 D T I M E ( 2 n c ) , N E X P = ⋃ c ≥ 0 N T I M E ( 2 n c ) . \mathrm{EXP}=\bigcup_{c\ge0}\mathrm{DTIME}(2^{n^c}),\qquad\mathrm{NEXP}=\bigcup_{c\ge0}\mathrm{NTIME}(2^{n^c}). EXP = c ≥ 0 ⋃ DTIME ( 2 n c ) , NEXP = c ≥ 0 ⋃ NTIME ( 2 n c ) . P ⊆ N P ⊆ E X P ⊆ N E X P \mathrm P\subseteq\mathrm{NP}\subseteq\mathrm{EXP}\subseteq\mathrm{NEXP} P ⊆ NP ⊆ EXP ⊆ NEXP 若 E X P ≠ N E X P \mathrm{EXP}\ne\mathrm{NEXP} EXP = NEXP P ≠ N P \mathrm P\ne\mathrm{NP} P = NP (1)前两个包含关系已证,最后一个因确定性机器是非确定性机器的特例。
(2)只证逆否命题:设 P = N P \mathrm P=\mathrm{NP} P = NP E X P = N E X P \mathrm{EXP}=\mathrm{NEXP} EXP = NEXP L ∈ N T I M E ( 2 n c ) L\in\mathrm{NTIME}(2^{n^c}) L ∈ NTIME ( 2 n c ) M M M
断言 :L p a d = { ⟨ x , 1 2 ∣ x ∣ c ⟩ : x ∈ L } ∈ N P L_{\mathrm{pad}}=\{\langle x,1^{2^{|x|^c}}\rangle:x\in L\}\in\mathrm{NP} L pad = {⟨ x , 1 2 ∣ x ∣ c ⟩ : x ∈ L } ∈ NP y y y z z z y = ⟨ z , 1 2 ∣ z ∣ c ⟩ y=\langle z,1^{2^{|z|^c}}\rangle y = ⟨ z , 1 2 ∣ z ∣ c ⟩ M ( z ) M(z) M ( z ) M ( z ) M(z) M ( z ) O ( 2 ∣ z ∣ c ) O(2^{|z|^c}) O ( 2 ∣ z ∣ c ) ∣ y ∣ |y| ∣ y ∣ ∣ y ∣ |y| ∣ y ∣
于是 L p a d ∈ N P = P L_{\mathrm{pad}}\in\mathrm{NP}=\mathrm P L pad ∈ NP = P x ∈ L x\in L x ∈ L y = ⟨ x , 1 2 ∣ x ∣ c ⟩ y=\langle x,1^{2^{|x|^c}}\rangle y = ⟨ x , 1 2 ∣ x ∣ c ⟩ O ( 2 ∣ x ∣ c ) O(2^{|x|^c}) O ( 2 ∣ x ∣ c ) L p a d L_{\mathrm{pad}} L pad y y y p o l y ( ∣ y ∣ ) = 2 O ( ∣ x ∣ c ) \mathrm{poly}(|y|)=2^{O(|x|^c)} poly ( ∣ y ∣ ) = 2 O ( ∣ x ∣ c ) L ∈ E X P L\in\mathrm{EXP} L ∈ EXP □ \square □
这一技术称为填充 (padding):人为地把输入变长,使相对于输入长度的运行时间「变小」。它说明类之间的相等 会向上传递(P = N P ⇒ E X P = N E X P \mathrm P=\mathrm{NP}\Rightarrow\mathrm{EXP}=\mathrm{NEXP} P = NP ⇒ EXP = NEXP 分离 会向下传递。
9. P vs NP 的现状# NP 的哲学意义在于:识别答案的正确性往往比想出答案容易。它与数学证明紧密相关:能否在证明长度的多项式时间内找到 证明?P = N P \mathrm P=\mathrm{NP} P = NP P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
P vs NP 是 Clay 数学研究所的七个千禧年大奖难题之一(其中 Poincaré 猜想已被解决)。证明 P = N P \mathrm P=\mathrm{NP} P = NP P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
对角线法 :能否像构造 UC 那样,直接构造一个 NP 语言,使每个多项式时间算法都在某个输入上出错?
电路复杂性 :只需证明某个 NP 完全问题不能被较小的与、或、非门电路计算;
证明复杂性 :若能证明 TAUTOLOGY 没有简短的证明,即得 N P ≠ c o N P \mathrm{NP}\ne\mathrm{coNP} NP = coNP P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
新的希望包括 Mulmuley 与 Sohoni 的几何复杂性理论 ,它涉及代数几何、表示论、量子群,并需要一个类似 Riemann 假设的命题;Mulmuley 估计这一纲领需要约 100 年才能完成(如果它可行的话)。2010 年 Deolalikar 用统计物理与有限模型论宣称证明了 P ≠ N P \mathrm P\ne\mathrm{NP} P = NP
三重障碍
已知的几类技术被证明不足以解决 P vs NP:相对化 (Baker–Gill–Solovay 1975):存在预言机 A , B A,B A , B P A = N P A \mathrm P^A=\mathrm{NP}^A P A = NP A P B ≠ N P B \mathrm P^B\ne\mathrm{NP}^B P B = NP B 自然证明 (Razborov–Rudich 1994):在单向函数存在的假设下,一大类电路下界论证无法证明 P ≠ N P \mathrm P\ne\mathrm{NP} P = NP 代数化 (Aaronson–Wigderson 2008)则堵住了对相对化的代数推广。
10. 小结# 归约 变量部件 子句部件 / 约束 S A T ≤ p d H A M P A T H \mathrm{SAT}\le_p\mathrm{dHAMPATH} SAT ≤ p dHAMPATH 双向链,走向即赋值 子句顶点只能从方向正确的链绕道访问 S A T ≤ p S E T C O V E R \mathrm{SAT}\le_p\mathrm{SETCOVER} SAT ≤ p SETCOVER S i , t , S i , f S_{i,t},S_{i,f} S i , t , S i , f 新元素 m + i m+i m + i I N D S E T ≤ p V C , C L I Q U E \mathrm{INDSET}\le_p\mathrm{VC},\mathrm{CLIQUE} INDSET ≤ p VC , CLIQUE — 取补集、取补图 3 S A T ≤ p S U B S E T - S U M \mathrm{3SAT}\le_p\mathrm{SUBSET\text{-}SUM} 3SAT ≤ p SUBSET - SUM 变量位为 1 子句位为 4,填充数补足;各位不进位 S U B S E T - S U M ≤ p P A R T I T I O N \mathrm{SUBSET\text{-}SUM}\le_p\mathrm{PARTITION} SUBSET - SUM ≤ p PARTITION — 两个大数 2 Σ − W 2\Sigma-W 2Σ − W Σ + W \Sigma+W Σ + W S U B S E T - S U M ≤ p S C H E D U L E \mathrm{SUBSET\text{-}SUM}\le_p\mathrm{SCHEDULE} SUBSET - SUM ≤ p SCHEDULE — 任务 0 卡住 [ W , W + 1 ] [W,W+1] [ W , W + 1 ] [ 0 , W ] [0,W] [ 0 , W ]
类 定义 完全问题 NP ∃ u \exists u ∃ u SAT、3SAT、INDSET、…… coNP ∀ u \forall u ∀ u TAUTOLOGY、S A T ‾ \overline{\mathrm{SAT}} SAT EXP / NEXP 指数时间(非)确定性 —
NP 完全问题构成一个巨大的等价类,归约在其中自由穿行;搜索与判定也被证明等价。理论告诉我们,若 P ≠ N P \mathrm P\ne\mathrm{NP} P = NP 拓展可解性的边界 。