稳定匹配是算法设计的第一个例子:给出一个过程,证明它终止、给出正确的解,再估计它的代价。图则是此后几乎所有问题的语言,图上的算法大多从遍历开始,而遍历的代价是 $O(m+n)$,与读入图的代价相同。
1. 引入:稳定匹配
有 $n$ 位男士 $M$ 与 $n$ 位女士 $W$,每人对异性有一个严格的偏好排序。匹配 $S\subseteq M\times W$ 中每人至多出现一次;每人恰好出现一次时称为完美匹配。对完美匹配 $S$,若 $(m,w)\notin S$,而 $m$ 比起自己的配偶更喜欢 $w$,$w$ 比起自己的配偶也更喜欢 $m$,则称 $(m,w)$ 为不稳定对。没有不稳定对的完美匹配称为稳定匹配。
给定 $2n$ 个人的偏好表,求一个稳定匹配(若存在)。
完美匹配共 $n!$ 个,逐一检查是否存在不稳定对,复杂度为 $O(n!\,n^2)$;输入是 $2n$ 张长为 $n$ 的偏好表,读入即需 $\Omega(n^2)$。
稳定匹配是否总存在并不显然。若不区分两方(室友问题:$2n$ 个人两两配对),它就可能不存在:
室友问题的反例
四个人 $a,b,c,d$,偏好为 $a:\ b>c>d$,$b:\ c>a>d$,$c:\ a>b>d$,$d$ 任意。无论 $d$ 与谁配对,剩下两人配成一对。若 $d$ 与 $a$ 配对,则 $c$ 最喜欢 $a$,$a$ 也宁愿要 $c$ 而非 $d$,$(a,c)$ 不稳定;$d$ 与 $b$、$c$ 配对时同理,三人的偏好轮换对称。
Gale 与 Shapley(1962)给出了一个“提议—拒绝”的过程:未配对的男士按偏好从高到低依次向女士提议;女士只保留目前收到的最好的提议,拒绝其余的。
算法实现
\begin{algorithm}
\caption{Gale-Shapley:稳定匹配}
\begin{algorithmic}
\PROCEDURE{GaleShapley}{男士与女士的偏好表}
  \STATE $S \gets \emptyset$
  \WHILE{存在未配对、且未向所有女士提议过的男士 $m$}
    \STATE $w \gets m$ 的偏好表中他尚未提议过的排名最高的女士
    \IF{$w$ 未配对}
      \STATE $S \gets S \cup \{(m, w)\}$
    \ELIF{$w$ 比起当前配偶 $m'$ 更喜欢 $m$}
      \STATE $S \gets S - \{(m', w)\} \cup \{(m, w)\}$ \COMMENT{$m'$ 重新成为未配对}
    \ELSE
      \STATE $w$ 拒绝 $m$
    \ENDIF
  \ENDWHILE
  \RETURN $S$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
过程中有两个单调的量:男士提议的对象越来越差;女士一旦配对就不会再落单,配偶只会越来越好。分析就建立在这两点之上。
while 循环至多执行 $n^2$ 次。
每次循环中,某位男士向一位他从未提议过的女士提议。“已发生的提议”只增不减,而至多有 $n^2$ 个不同的(男士,女士)对。$\square$
算法终止时,所有人都已配对。
设男士 $m$ 终止时未配对,则必有一位女士 $w$ 未配对。女士一旦被提议就不会再落单,故 $w$ 从未被提议过;但 $m$ 未配对而循环已终止,说明他已向所有女士提议过,矛盾。$\square$
算法返回的匹配 $S^*$ 中没有不稳定对。
设 $(m,w)\notin S^*$,$m$ 在 $S^*$ 中与 $w'$ 配对。若 $m$ 从未向 $w$ 提议,由于他按偏好从高到低提议,他更喜欢 $w'$;若 $m$ 向 $w$ 提议过,则他当时或之后被 $w$ 拒绝,而女士的配偶只会越来越好,故 $w$ 更喜欢她最终的配偶。两种情形下 $(m,w)$ 都不是不稳定对。$\square$
对任意偏好表,Gale–Shapley 算法都在至多 $n^2$ 轮后返回一个稳定匹配。特别地,稳定匹配总是存在。
2. 实现:与输入同阶
$n^2$ 轮只是轮数的上界。要使总时间为 $O(n^2)$,每一轮必须在 $O(1)$ 内完成,即以下四个操作都是常数时间:
找一位未配对的男士:用链表(或栈)维护未配对的男士,取出与放回都是 $O(1)$;
找他尚未提议过的最好的女士:数组 $\mathrm{Next}[m]$ 记录他下一个要提议的位置,提议后无论结果都加一;
查女士的当前配偶:数组 $\mathrm{Current}[w]$,未配对时为空;
比较女士对两位男士的偏好:偏好表 $\mathrm{WomanPref}[w,i]$ 给出的是第 $i$ 名是谁,比较需要 $O(n)$;预先计算其逆 $\mathrm{Ranking}[w,m]$($m$ 在 $w$ 心中的名次),只需 $O(n^2)$ 的预处理,此后比较为 $O(1)$。
前三者只是选对数据结构,第四个则需要把输入转换成更适合算法的形式。合计 $O(n^2)$,与读入输入的下界同阶。
算法实现
\begin{algorithm}
\caption{Gale-Shapley 的 $O(n^2)$ 实现}
\begin{algorithmic}
\PROCEDURE{GaleShapleyArrays}{$\mathrm{ManPref}, \mathrm{WomanPref}$}
  \FORALL{$w$ 与 $i \gets 1, \dots, n$}
    \STATE $\mathrm{Ranking}[w, \mathrm{WomanPref}[w, i]] \gets i$ \COMMENT{预处理 $O(n^2)$}
  \ENDFOR
  \STATE 对一切 $m$:$\mathrm{Next}[m] \gets 1$;对一切 $w$:$\mathrm{Current}[w] \gets \mathrm{null}$
  \STATE $F \gets$ 全部男士组成的栈
  \WHILE{$F$ 非空}
    \STATE $m \gets$ \CALL{Pop}{$F$},$w \gets \mathrm{ManPref}[m, \mathrm{Next}[m]]$,$\mathrm{Next}[m] \gets \mathrm{Next}[m] + 1$
    \STATE $m' \gets \mathrm{Current}[w]$
    \IF{$m' = \mathrm{null}$}
      \STATE $\mathrm{Current}[w] \gets m$
    \ELIF{$\mathrm{Ranking}[w, m] < \mathrm{Ranking}[w, m']$}
      \STATE $\mathrm{Current}[w] \gets m$,\CALL{Push}{$F, m'$}
    \ELSE
      \STATE \CALL{Push}{$F, m$} \COMMENT{被拒绝,下一轮继续向下一位提议}
    \ENDIF
  \ENDWHILE
  \RETURN $\{(\mathrm{Current}[w], w) : w \in W\}$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
由“完美”引理,栈中的男士总还有没提议过的女士,$\mathrm{Next}[m]$ 不会越界。
3. 理解解:男方最优
同一组偏好可以有多个稳定匹配,例如
| 第 1 | 第 2 | 第 3 | 第 1 | 第 2 | 第 3 | ||
|---|---|---|---|---|---|---|---|
| $X$ | $A$ | $B$ | $C$ | $A$ | $Y$ | $X$ | $Z$ |
| $Y$ | $B$ | $A$ | $C$ | $B$ | $X$ | $Y$ | $Z$ |
| $Z$ | $A$ | $B$ | $C$ | $C$ | $X$ | $Y$ | $Z$ |
中 $\{X\text{–}A,\ Y\text{–}B,\ Z\text{–}C\}$ 与 $\{X\text{–}B,\ Y\text{–}A,\ Z\text{–}C\}$ 都是稳定的:前者男士都得到首选,后者女士 $A,B$ 都得到首选。算法中“选一位未配对的男士”是任意的,不同的执行顺序会得到不同的结果吗?
若存在某个稳定匹配使 $m$ 与 $w$ 配对,则称 $w$ 是 $m$ 的可行配偶。记 $\mathrm{best}(m)$ 为 $m$ 的可行配偶中他最喜欢的一位,$\mathrm{worst}(w)$ 为 $w$ 的可行配偶中她最不喜欢的一位。
Gale–Shapley 的每一次执行都返回 $S^*=\{(m,\mathrm{best}(m)) : m\in M\}$。
设某次执行中,某位男士最终的配偶不是 $\mathrm{best}(m)$。由于男士按偏好从高到低提议,他一定被某位可行配偶拒绝过。考虑执行中第一次有男士被可行配偶拒绝:设 $Y$ 被 $A$ 拒绝,$A$ 是 $Y$ 的可行配偶,于是存在稳定匹配 $S$ 使 $Y$ 与 $A$ 配对。
$Y$ 被拒绝时,$A$ 选择了(或保留了)某位男士 $Z$,故 $A$ 更喜欢 $Z$ 而非 $Y$。设 $Z$ 在 $S$ 中的配偶为 $B$。这是第一次有人被可行配偶拒绝,此时 $Z$ 尚未被任何可行配偶(包括 $B$)拒绝过;而 $Z$ 已经向 $A$ 提议,说明他排在 $B$ 之前提议了 $A$,即 $Z$ 更喜欢 $A$ 而非 $B$。于是在 $S$ 中,$A$ 更喜欢 $Z$,$Z$ 更喜欢 $A$,$(Z,A)$ 是不稳定对,与 $S$ 稳定矛盾。$\square$
由此,“每位男士都得到最好的可行配偶”这一看似过分的要求,竟然给出一个匹配,而且是稳定的。代价由另一方承担:
在 $S^*$ 中,每位女士都与 $\mathrm{worst}(w)$ 配对。
设 $(Z,A)\in S^*$,但存在稳定匹配 $S$ 使 $A$ 与某位她更不喜欢的 $Y$ 配对。设 $Z$ 在 $S$ 中的配偶为 $B$。由男方最优,$A=\mathrm{best}(Z)$,而 $B$ 是 $Z$ 的另一位可行配偶,故 $Z$ 更喜欢 $A$;$A$ 更喜欢 $Z$ 而非 $Y$。于是 $(Z,A)$ 在 $S$ 中不稳定,矛盾。$\square$
提议的一方占优。由女士提议得到的就是女方最优、男方最劣的稳定匹配,上例中两个稳定匹配正是如此。
谎报偏好:已知其余所有人的偏好且使用男士提议的算法,有人能通过谎报自己的偏好得到更好的配偶吗?
男士不能(Dubins–Freedman,1981),女士可以。对上例稍作修改,设女士 $A$ 的真实偏好为 $Y>X>Z$,$B,C$ 都为 $X>Y>Z$,男士 $X:A>B>C$,$Y:B>A>C$,$Z:A>B>C$。如实申报时算法给出 $\{X\text{–}A,\ Y\text{–}B,\ Z\text{–}C\}$,$A$ 得到第二选择 $X$。若 $A$ 谎称 $Y>Z>X$:$X,Y,Z$ 先分别向 $A,B,A$ 提议,$A$ 留下 $Z$、拒绝 $X$;$X$ 转向 $B$,$B$ 留下 $X$、拒绝 $Y$;$Y$ 转向 $A$,$A$ 留下 $Y$、拒绝 $Z$;$Z$ 依次被 $B$ 拒绝、被 $C$ 接受。结果为 $\{X\text{–}B,\ Y\text{–}A,\ Z\text{–}C\}$,$A$ 得到了真实的首选。$\square$
2012 年诺贝尔经济学奖
Shapley 因稳定匹配理论与 Gale–Shapley 算法,Roth 因将其用于住院医师与医院的匹配(美国 NRMP 采用申请者提议的版本)、学生择校与器官捐献配对,共同获得 2012 年诺贝尔经济学奖。
4. 五个代表性问题
稳定匹配之后,几个形式相近的问题刻画了算法设计的不同难度:
| 问题 | 目标 | 已知结果 |
|---|---|---|
| 区间调度 | 两两不相交的区间的最大个数 | 贪心,$O(n\log n)$ |
| 带权区间调度 | 两两不相交的区间的最大总权 | 动态规划,$O(n\log n)$ |
| 二分图匹配 | 二分图中边数最多的匹配 | 最大流,$O(mn)$ |
| 独立集 | 图中两两不相邻的节点的最大个数 | NP 完全 |
| 竞争性设施选址 | 两人轮流选不相邻的带权节点,能否保证总权达到给定值 | PSPACE 完全 |
后三个是图上的问题,而前三个都是(带权)独立集的特例:以区间为节点、相交的区间之间连边(区间图),区间调度就是区间图上的独立集;以二分图的边为节点、有公共端点的边之间连边,匹配就是这个图上的独立集。同一个问题,在一般图上是 NP 完全的,在特殊结构的图上却有高效算法。区间调度的贪心见算法设计:贪心。
5. 图:定义与表示
无向图 $G=(V,E)$ 由节点集 $V$ 与边集 $E$ 组成,每条边连接一对节点,记 $n=|V|$,$m=|E|$。有向图中边 $(u,v)$ 有方向,从尾 $u$ 指向头 $v$。路径是节点序列 $v_1,\dots,v_k$,相邻两点有边相连;节点互不相同时称为简单路径。任意两点间都有路径的无向图称为连通的。$v_1=v_k$、$k>2$ 且前 $k-1$ 个节点互不相同的路径称为圈。
无向图中 $\sum_{u\in V}\deg(u)=2m$。
每条边恰好对它的两个端点的度各贡献 $1$。$\square$
在算法中,同一个图可以有不同的表示,各有所长:
| 空间 | 判断 $(u,v)\in E$ | 遍历 $u$ 的邻居 | 遍历全部边 | |
|---|---|---|---|---|
| 邻接矩阵 | $\Theta(n^2)$ | $O(1)$ | $\Theta(n)$ | $\Theta(n^2)$ |
| 邻接表 | $\Theta(m+n)$ | $O(\deg u)$ | $O(\deg u)$ | $\Theta(m+n)$ |
| 关联矩阵 | $\Theta(mn)$ | $O(m)$ | $O(m)$ | $\Theta(mn)$ |
| 前向星 | $\Theta(m+n)$ | $O(\deg u)$ | $O(\deg u)$ | $\Theta(m+n)$ |
邻接矩阵 $A_{uv}=[(u,v)\in E]$ 适合稠密图与 $O(1)$ 的查询;图通常是稀疏的($m\ll n^2$),此时邻接表更好。由握手引理,遍历全部邻接表的代价是 $\Theta(m+n)$,这正是下文“线性时间”的含义。
前向星是邻接表的数组形式:将边按尾节点排序存入数组,再用 $\mathrm{point}[u]$ 记录从 $u$ 出发的第一条边的编号,$u$ 的出边即编号 $\mathrm{point}[u],\dots,\mathrm{point}[u+1]-1$ 的边。例如有向图 $1\to2,\ 1\to3,\ 2\to4,\ 3\to2,\ 4\to3,\ 4\to5,\ 5\to3,\ 5\to4$:
| 节点 $u$ | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| $\mathrm{point}[u]$ | 1 | 3 | 4 | 5 | 7 | 9 |
| 边 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 尾 | 1 | 1 | 2 | 3 | 4 | 4 | 5 | 5 |
| 头 | 2 | 3 | 4 | 2 | 3 | 5 | 3 | 4 |
| 权 | 8 | 9 | 6 | 4 | 0 | 3 | 6 | 7 |
($\mathrm{point}[6]=9$ 是哨兵。)同理可按头节点排序得到反向星,用于遍历入边。
关联矩阵 $B\in\{-1,0,1\}^{n\times m}$ 的每列对应一条边:边 $e=(u,v)$ 在第 $u$ 行为 $1$,第 $v$ 行为 $-1$,其余为 $0$。它不适合遍历,但把图论性质变成了线性代数性质:
若有向图(忽略方向后)连通,则其关联矩阵的秩为 $n-1$。
每列恰有一个 $1$ 与一个 $-1$,各行之和为零,故秩 $\le n-1$。设 $x^\top B=0$,则对每条边 $(u,v)$ 有 $x_u-x_v=0$;沿路径传递,连通图上 $x$ 为常向量,即 $B$ 的左零空间是一维的,秩为 $n-1$。$\square$
无圈的连通图称为树。选定一个根 $r$ 并将边背离 $r$ 定向,就得到有根树,其中有父节点、子节点、祖先与后代的概念。
设 $G$ 是 $n$ 个节点的无向图,以下三条中任意两条蕴含第三条:(1)$G$ 连通;(2)$G$ 无圈;(3)$G$ 有 $n-1$ 条边。
先证树有 $n-1$ 条边:树中最长的简单路径的端点只有一个邻居(否则可以延长路径或形成圈),删去这个叶子仍是树,归纳即得。
(1)(2)$\Rightarrow$(3)即上述结论。(1)(3)$\Rightarrow$(2):若有圈,反复删去圈上的边,图保持连通,直到无圈,得到一棵边数少于 $n-1$ 的树,矛盾。(2)(3)$\Rightarrow$(1):设 $G$ 有 $c$ 个连通块,每块都是树,边数合计 $n-c=n-1$,故 $c=1$。$\square$
6. 连通性:BFS 与 DFS
给定图 $G$ 与节点 $s,t$,判断是否存在 $s$ 到 $t$ 的路径;若存在,求最短路径的边数。
枚举所有路径是指数级的;算法可能需要看过每条边才能断定不连通,下界为 $\Omega(m+n)$。
广度优先搜索(BFS)则考虑从 $s$ 出发逐层向外扩展:$L_0=\{s\}$;$L_{j+1}$ 由不在 $L_0,\dots,L_j$ 中、但与 $L_j$ 中某点相邻的节点组成。
$L_j$ 恰好由与 $s$ 距离为 $j$ 的节点组成;$s$ 到 $t$ 有路径当且仅当 $t$ 出现在某一层中。
对 $j$ 归纳。$L_{j+1}$ 中的点与 $L_j$ 中的点相邻,距离至多 $j+1$;又不在前 $j$ 层中,由归纳假设距离不小于 $j+1$。反之,距离为 $j+1$ 的点在最短路上的前一个点距离为 $j$,属于 $L_j$,于是它属于 $L_{j+1}$(不会更早出现,因为距离大于 $j$)。$\square$
每个 $v\in L_{j+1}$ 记下发现它的 $L_j$ 中的节点作为父节点,就得到以 $s$ 为根的 BFS 树。
设 $x\in L_i$,$y\in L_j$,且 $(x,y)$ 是 $G$ 的边,则 $|i-j|\le1$。
不妨设 $i < j$。处理 $x$ 时会扫描到边 $(x,y)$:若 $y$ 此时尚未被发现,它就会被放入 $L_{i+1}$;否则它在更早已被发现,层数不超过 $i+1$。总之 $j\le i+1$。$\square$
用队列实现时,每个节点至多入队一次,出队时扫描其邻接表,代价为 $O(\deg u)$;由握手引理,总代价为 $O(m+n)$。
算法实现
\begin{algorithm}
\caption{BFS:分层与最短跳数}
\begin{algorithmic}
\PROCEDURE{BFS}{$G, s$}
  \STATE 对一切 $v$:$\mathrm{dist}(v) \gets \infty$,$\mathrm{parent}(v) \gets \mathrm{null}$
  \STATE $\mathrm{dist}(s) \gets 0$,$Q \gets$ 只含 $s$ 的队列
  \WHILE{$Q$ 非空}
    \STATE $u \gets$ \CALL{Dequeue}{$Q$}
    \FORALL{$u$ 的邻居 $v$}
      \IF{$\mathrm{dist}(v) = \infty$}
        \STATE $\mathrm{dist}(v) \gets \mathrm{dist}(u) + 1$,$\mathrm{parent}(v) \gets u$ \COMMENT{$v \in L_{\mathrm{dist}(v)}$}
        \STATE \CALL{Enqueue}{$Q, v$}
      \ENDIF
    \ENDFOR
  \ENDWHILE
  \RETURN $\mathrm{dist}, \mathrm{parent}$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}深度优先搜索(DFS)则考虑沿一条路一直走下去,走不通再回溯,就像在迷宫中一手扶墙。以 DFS 调用关系为父子关系,得到 DFS 树。
设 $T$ 是 DFS 树,$(x,y)$ 是 $G$ 中不在 $T$ 里的边,则 $x,y$ 中一个是另一个的祖先。
不妨设 DFS 先访问 $x$。DFS$(x)$ 会扫描边 $(x,y)$;由于它不是树边,扫描时 $y$ 已被访问。$y$ 在 $x$ 之后、DFS$(x)$ 返回之前被访问(扫描 $(x,y)$ 时 DFS$(x)$ 尚未返回),而这段时间内访问的节点都是 $x$ 的后代。$\square$
用递归(或显式的栈)实现,同样是 $O(m+n)$。
算法实现
\begin{algorithm}
\caption{DFS:深度优先搜索}
\begin{algorithmic}
\PROCEDURE{DFS}{$u$}
  \STATE 将 $u$ 标记为已访问
  \FORALL{$u$ 的邻居 $v$}
    \IF{$v$ 未被访问}
      \STATE $\mathrm{parent}(v) \gets u$
      \STATE \CALL{DFS}{$v$}
    \ENDIF
  \ENDFOR
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
两者访问的节点集合相同,都是 $s$ 所在的连通块,只是树的形状不同:BFS 树又矮又宽,非树边只连接相邻层;DFS 树又高又窄,非树边只连接祖先与后代。两点的连通块要么相同、要么不相交,反复从未访问的节点出发搜索,即可在 $O(m+n)$ 内求出全部连通块。边带非负长度时,按距离而非层数扩展,就得到 Dijkstra 算法,见算法设计:贪心。
7. 二分图判定
若能把无向图的节点染成红、蓝两色,使每条边的两端颜色不同,则称其为二分图。
稳定匹配中男士与女士、调度中机器与任务都构成二分图。许多图问题在二分图上更简单(匹配),或从难解变为可解(独立集)。
给定无向图 $G$,判断它是否为二分图。
奇圈是一个显然的障碍:沿圈交替染色,绕一圈回到起点时颜色必须改变奇数次,矛盾。BFS 表明它也是唯一的障碍:
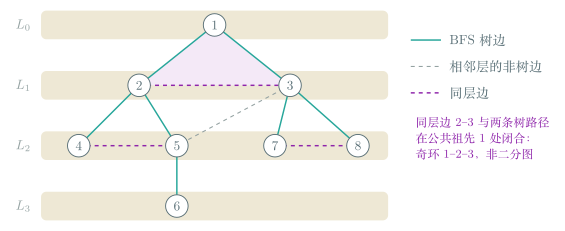
设 $G$ 连通,$L_0,L_1,\dots$ 是从 $s$ 出发 BFS 得到的层,则以下二者恰有一个成立:
- 没有边连接同一层的两点,此时 $G$ 是二分图;
- 有边连接同一层的两点,此时 $G$ 含奇圈,因而不是二分图。
(1)偶数层染红、奇数层染蓝。由 BFS 树引理,每条边连接相邻两层(同层已被排除),两端颜色不同。
(2)设边 $(x,y)$ 满足 $x,y\in L_j$。在 BFS 树中,$x$ 与 $y$ 到根的路径在最低公共祖先 $z\in L_i$($i < j$)处汇合。$z\to x$ 与 $z\to y$ 的树路径各有 $j-i$ 条边,再加上边 $(x,y)$,构成长为 $2(j-i)+1$ 的圈,是奇圈。$\square$
无向图是二分图,当且仅当它不含奇圈。
于是只需在每个连通块上 BFS,按层的奇偶染色,再检查每条边,共 $O(m+n)$。
算法实现
\begin{algorithm}
\caption{Is-Bipartite:二分图判定}
\begin{algorithmic}
\PROCEDURE{IsBipartite}{$G$}
  \FORALL{$v \in V$}
    \IF{$v$ 未被访问}
      \STATE $\mathrm{dist}(v) \gets 0$,从 $v$ 出发 BFS,求出该连通块内各点的 $\mathrm{dist}$ \COMMENT{不重置其它连通块}
    \ENDIF
  \ENDFOR
  \STATE $\mathrm{color}(v) \gets \mathrm{dist}(v) \bmod 2$ \COMMENT{按层的奇偶染色}
  \FORALL{边 $(x, y) \in E$}
    \IF{$\mathrm{color}(x) = \mathrm{color}(y)$}
      \RETURN \FALSE \COMMENT{同层边,存在奇圈}
    \ENDIF
  \ENDFOR
  \RETURN \TRUE
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
8. 有向图:强连通
在有向图中,BFS 与 DFS 沿出边进行即可,求出的是从 $s$ 可达的节点。反过来,求“哪些节点能到达 $s$”,只需在反图 $G^{\mathrm{rev}}$(每条边反向)上搜索,反图可在 $O(m+n)$ 内建出。
若 $u$ 到 $v$、$v$ 到 $u$ 都有路径,则称 $u,v$ 互相可达。任意两点都互相可达的有向图称为强连通的。
互相可达是等价关系(传递性:把 $u\to v$ 与 $v\to w$ 的路径接起来即可),其等价类称为强连通分量。两点的强连通分量要么相同,要么不相交。
任取节点 $s$,$G$ 强连通当且仅当每个节点都从 $s$ 可达、且 $s$ 从每个节点可达。因此可在 $O(m+n)$ 内判定强连通。
必要性显然。充分性:对任意 $u,v$,路径 $u\to s\to v$ 与 $v\to s\to u$ 都存在。算法上,在 $G$ 与 $G^{\mathrm{rev}}$ 上各从 $s$ 做一次 BFS,两次都访问到全部节点时返回“是”。$\square$
Tarjan(1972)进一步给出了在 $O(m+n)$ 内求出全部强连通分量的算法,见文末补充。
9. 有向无环图与拓扑序
不含有向圈的有向图称为有向无环图(DAG)。有向图的拓扑序是节点的一个排列 $v_1,\dots,v_n$,使每条边 $(v_i,v_j)$ 都满足 $i < j$。
DAG 刻画了先后约束:边 $(v_i,v_j)$ 表示任务 $v_i$ 必须先于 $v_j$,如课程的先修关系、模块的编译顺序、流水线中作业的输入输出依赖。拓扑序就是一个满足所有约束的执行顺序。
若 $G$ 有拓扑序,则 $G$ 是 DAG。
设 $G$ 有拓扑序 $v_1,\dots,v_n$,又有有向圈 $C$。取 $C$ 上下标最小的 $v_i$,以及 $C$ 上它的前一个节点 $v_j$,则 $(v_j,v_i)$ 是边且 $i < j$,与拓扑序的定义矛盾。$\square$
DAG 中必有入度为零的节点。
设每个节点都有入边,从任一节点出发反复沿入边倒退。$n+1$ 步后必然重复经过某个节点,两次经过之间的路径反过来就是有向圈。$\square$
$G$ 有拓扑序当且仅当 $G$ 是 DAG。
必要性即第一个引理。充分性对 $n$ 归纳:取入度为零的节点 $v$,$G-\{v\}$ 仍是 DAG,由归纳假设有拓扑序;把 $v$ 放在最前面,由于 $v$ 没有入边,所有边仍指向后方。$\square$
这个证明本身就是算法:反复取出入度为零的节点并删去。朴素地每次重新寻找需要 $O(n^2)$;维护每个节点剩余的入度 $\mathrm{count}(w)$ 与当前入度为零的节点集合 $Z$,删去 $v$ 时只需对每条出边 $(v,w)$ 将 $\mathrm{count}(w)$ 减一,每条边 $O(1)$,共 $O(m+n)$。若 $Z$ 在输出全部节点之前就空了,剩下的子图没有入度为零的节点,$G$ 含有向圈。
算法实现
\begin{algorithm}
\caption{Topological-Sort:拓扑排序}
\begin{algorithmic}
\PROCEDURE{TopologicalSort}{$G$}
  \STATE 对一切 $w$:$\mathrm{count}(w) \gets w$ 的入度 \COMMENT{扫描一遍,$O(m + n)$}
  \STATE $Z \gets \{w : \mathrm{count}(w) = 0\}$,$L \gets$ 空表
  \WHILE{$Z$ 非空}
    \STATE 从 $Z$ 中取出某个 $v$,追加到 $L$ 末尾
    \FORALL{边 $(v, w)$}
      \STATE $\mathrm{count}(w) \gets \mathrm{count}(w) - 1$
      \IF{$\mathrm{count}(w) = 0$}
        \STATE $Z \gets Z \cup \{w\}$
      \ENDIF
    \ENDFOR
  \ENDWHILE
  \IF{$|L| < n$}
    \RETURN 含有向圈
  \ENDIF
  \RETURN $L$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
10. 几个小例子
好人与坏人:$n$ 位男士与 $n$ 位女士中各有 $k$ 位“好人”($1\le k\le n-1$),每个人都把所有异性好人排在所有异性坏人之前。证明在任何稳定匹配中,每位好男士都与好女士配对。
设稳定匹配 $S$ 中好男士 $m$ 与坏女士配对。其余好男士只有 $k-1$ 位,不足以与全部 $k$ 位好女士配对,故有好女士 $w$ 与坏男士配对。$m$ 与 $w$ 都更喜欢对方(好人)而非现任(坏人),$(m,w)$ 不稳定,矛盾。$\square$
禁止配对:给定禁止配对的集合 $F\subseteq M\times W$,每人只对允许的异性排序;此时匹配不必完美。称匹配 $S$ 稳定,若不存在以下四种情形:(i)$(m,w),(m',w')\in S$,$(m,w')\notin F$,$m$ 更喜欢 $w'$ 而 $w'$ 更喜欢 $m$;(ii)$(m,w)\in S$,$m'$ 单身,$(m',w)\notin F$,$w$ 更喜欢 $m'$;(iii)$(m,w)\in S$,$w'$ 单身,$(m,w')\notin F$,$m$ 更喜欢 $w'$;(iv)$m,w$ 都单身且 $(m,w)\notin F$。稳定匹配总存在吗?
存在。将 Gale–Shapley 的循环条件改为“存在单身、且尚未向每位允许的女士都提议过的男士”,其余不变。终止性与原算法相同。终止时,单身男士已向所有允许的女士提议过,单身女士从未被提议过。逐一排除四种情形:(i)(ii)中 $m$(或 $m'$)向 $w'$(或 $w$)提议过且被拒,而女士的配偶只会变好,矛盾;(iii)中 $w'$ 从未被提议,$m$ 没有向她提议过,说明他更喜欢现任,矛盾;(iv)中单身的 $m$ 向允许的 $w$ 提议过,$w$ 不会单身,矛盾。$\square$
拓扑序计数:DAG 的边为 $a\to b$,$a\to c$,$c\to d$,$b\to e$,$d\to e$,它有几个拓扑序?
拓扑序的第一个节点必须入度为零,最后一个必须出度为零,故 $a$ 在最前、$e$ 在最后。中间 $c$ 必须在 $d$ 之前,$b$ 可以在二者之前、之间或之后,共 $3$ 个:$a,b,c,d,e$;$a,c,b,d,e$;$a,c,d,b,e$。$\square$
机器人避让:无向图 $G$ 上有两个机器人,分别从 $a$、$b$ 出发前往 $c$、$d$。每一步恰有一个机器人沿一条边移动一步,且任何时刻两者在 $G$ 中的距离都必须大于 $r$(起点与终点满足这一条件)。在多项式时间内判断是否存在这样的移动方案。
在 $G$ 上直接思考“下一步该移动谁”很困难;改为在构型空间中搜索。构造图 $H$:节点是有序对 $(u,v)$(两个机器人的位置),$(u,v)$ 与 $(u',v)$ 相连当 $(u,u')\in E$,$(u,v)$ 与 $(u,v')$ 相连当 $(v,v')\in E$。删去所有距离 $d_G(u,v)\le r$ 的节点得到 $H'$,则合法方案恰好对应 $H'$ 中 $(a,b)$ 到 $(c,d)$ 的路径。
$H'$ 至多 $n^2$ 个节点;节点 $(u,v)$ 的度为 $\deg u+\deg v$,由握手引理共 $O(mn)$ 条边。从每个节点 BFS 求出 $G$ 中所有点对的距离需 $O(n(m+n))$,最后在 $H'$ 上 BFS 需 $O(mn+n^2)$,合计 $O(mn+n^2)$。$\square$
算法实现
\begin{algorithm}
\caption{Robots:构型空间中的搜索}
\begin{algorithmic}
\PROCEDURE{Robots}{$G, a, b, c, d, r$}
  \FORALL{$u \in V$}
    \STATE \CALL{BFS}{$G, u$},得到 $d_G(u, \cdot)$ \COMMENT{共 $O(n(m + n))$}
  \ENDFOR
  \STATE $V' \gets \{(u, v) : d_G(u, v) > r\}$
  \STATE $E' \gets \{((u, v), (u', v)) : (u, u') \in E\} \cup \{((u, v), (u, v')) : (v, v') \in E\}$,限制在 $V'$ 上
  \STATE 在 $H' = (V', E')$ 中从 $(a, b)$ 出发 \CALL{BFS}{} \COMMENT{$O(mn + n^2)$}
  \RETURN $(c, d)$ 是否被访问到
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
11. 小结
| 问题 | 算法 | 复杂度 | 关键 |
|---|---|---|---|
| 稳定匹配 | Gale–Shapley | $O(n^2)$ | 提议单调变差、配偶单调变好;逆偏好表使比较为 $O(1)$ |
| $s$-$t$ 连通 / 最短跳数 | BFS | $O(m+n)$ | 第 $j$ 层恰为距离 $j$ 的点;边只连接相邻层 |
| 连通块 | BFS / DFS | $O(m+n)$ | 连通块相同或不相交 |
| 二分图判定 | BFS 按层染色 | $O(m+n)$ | 奇圈是唯一的障碍 |
| 强连通判定 | $G$ 与 $G^{\mathrm{rev}}$ 上各一次 BFS | $O(m+n)$ | 互相可达经过 $s$ 传递 |
| 拓扑排序 | 反复删去入度为零的点 | $O(m+n)$ | DAG 必有源点;维护剩余入度 |
稳定匹配的分析示范了算法分析的全部要素:用单调量证明终止,用不变量证明正确,再为每一步选择数据结构使总代价与输入同阶。图上的基本问题则几乎都归结为一次遍历:选对表示(邻接表)使遍历为 $O(m+n)$,再从遍历留下的结构(层、树、入度)中读出答案。
12. 补充:强连通分量与缩点
强连通一节只判定了整个图是否强连通。一般的有向图可以分解为强连通分量,而分量之间的结构恰好是上一节的 DAG。
把每个强连通分量缩成一个点,分量 $C\ne C'$ 之间有边 $C\to C'$ 当且仅当原图中有从 $C$ 到 $C'$ 的边,则得到的图是 DAG。
若缩点后有有向圈 $C_1\to\dots\to C_k\to C_1$,则圈上各分量的节点都互相可达,应属于同一个分量,矛盾。$\square$
于是任何有向图都是“强连通分量组成的 DAG”。求强连通分量的关键是找到缩点 DAG 的一个汇(没有出边的分量):从汇中任一点出发搜索,恰好访问这个分量,不会漏到别处。DFS 的完成时间可以找到它。对整个图反复从未访问的点发起 DFS,记 $\mathrm{post}(u)$ 为 DFS$(u)$ 返回的时刻。
若调用 DFS$(u)$ 时,存在一条从 $u$ 出发、经过的节点全部未访问的路径到达 $v$,则 $v$ 在 DFS$(u)$ 返回前被访问。
设路径上有节点在 DFS$(u)$ 返回时仍未访问,取其中第一个 $v'$,其前驱 $p$ 已在 DFS$(u)$ 期间被访问。DFS$(p)$ 扫描边 $(p,v')$ 时 $v'$ 未访问,就会调用 DFS$(v')$,矛盾。$\square$
设 $C\ne C'$ 是强连通分量,且原图中有从 $C$ 到 $C'$ 的边,则 $\max_{u\in C}\mathrm{post}(u) > \max_{v\in C'}\mathrm{post}(v)$。
设 $x$ 是 $C\cup C'$ 中最先被访问的节点。若 $x\in C$,访问 $x$ 时 $C\cup C'$ 全部未访问且都从 $x$ 可达,由白色路径引理,它们都在 DFS$(x)$ 返回前完成,故 $\mathrm{post}(x)$ 大于 $C'$ 中所有点的完成时间。若 $x\in C'$,则 $C$ 从 $C'$ 不可达(否则二者互相可达),DFS$(x)$ 返回时 $C'$ 已全部完成而 $C$ 尚未被访问,$C$ 中各点的完成时间都更晚。$\square$
于是完成时间最大的点位于缩点 DAG 的一个源(没有入边的分量)中;在反图中源变成汇。由此得到 Kosaraju–Sharir 算法:
算法实现
\begin{algorithm}
\caption{Kosaraju-Sharir:强连通分量}
\begin{algorithmic}
\PROCEDURE{SCC}{$G$}
  \STATE 在 $G$ 上反复从未访问的节点调用 DFS,按完成时间降序记录节点,得到 $P$
  \STATE 构造反图 $G^{\mathrm{rev}}$,将所有节点重新标为未访问
  \FORALL{$u \in P$,按降序}
    \IF{$u$ 未被访问}
      \STATE 在 $G^{\mathrm{rev}}$ 上调用 \CALL{DFS}{$u$},本次访问到的节点构成一个强连通分量
    \ENDIF
  \ENDFOR
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
Kosaraju–Sharir 算法在 $O(m+n)$ 内正确求出全部强连通分量。
对已求出的分量个数归纳。设已正确求出若干分量,$u$ 是剩余节点中完成时间最大的,所在分量为 $C$。由完成时间引理,原图中剩余的其它分量都没有指向 $C$ 的边,即反图中 $C$ 只能指向已求出的分量,而它们都已被访问。反图中 $C$ 内部互相可达,故从 $u$ 出发的 DFS 恰好访问 $C$。两次 DFS 与构造反图各为 $O(m+n)$。$\square$
特别地,若 $G$ 本身是 DAG,每个分量只有一个点,完成时间引理说的是:每条边 $(u,v)$ 都满足 $\mathrm{post}(u) > \mathrm{post}(v)$。于是按完成时间降序排列节点就是一个拓扑序,这是拓扑排序的另一种 $O(m+n)$ 实现。Tarjan 的算法只用一次 DFS,为每个节点维护它经由后代与一条非树边能回到的、仍在栈中的最早节点(low-link),在 DFS 返回时就地识别出每个分量的根,复杂度同样为 $O(m+n)$。